Mặc dù hệ số R bình phương hiệu chỉnh chưa có một ngưỡng chuẩn thống nhất để xác định mức độ chấp nhận hay vi phạm của mô hình hồi quy, nhiều nghiên cứu thực nghiệm cho thấy giá trị R bình phương hiệu chỉnh quá thấp thường phản ánh mức độ phù hợp kém giữa mô hình và dữ liệu quan sát. Trong những trường hợp này, nhà nghiên cứu có thể cân nhắc áp dụng các kỹ thuật xử lý và điều chỉnh mô hình nhằm cải thiện giá trị R bình phương hiệu chỉnh khi thực hiện phân tích hồi quy trên phần mềm SPSS.
1. Nhận thức đầy đủ về ý nghĩa của R bình phương và R bình phương hiệu chỉnh
Trong phân tích hồi quy tuyến tính, R bình phương và R bình phương hiệu chỉnh là hai chỉ tiêu thống kê quan trọng được sử dụng để đánh giá mức độ giải thích của mô hình đối với biến phụ thuộc. Cụ thể:
R bình phương phản ánh tỷ lệ biến thiên của biến phụ thuộc được giải thích bởi tập hợp các biến độc lập trong mô hình hồi quy.
Ví dụ, nếu giá trị R bình phương đạt 0,8, điều này cho thấy 80% sự biến thiên của biến phụ thuộc được lý giải bởi các biến độc lập được đưa vào mô hình, trong khi 20% còn lại có thể xuất phát từ các yếu tố chưa được xem xét hoặc do sai số ngẫu nhiên.
R bình phương hiệu chỉnh là chỉ số được điều chỉnh từ R bình phương nhằm tính đến số lượng biến độc lập trong mô hình. Khác với R bình phương, giá trị R bình phương hiệu chỉnh có thể tăng hoặc giảm khi bổ sung thêm biến độc lập, tùy thuộc vào mức độ đóng góp thực sự của biến đó vào khả năng giải thích của mô hình.
Chỉ số này giúp hạn chế hiện tượng đánh giá quá mức độ phù hợp của mô hình trong trường hợp đưa vào quá nhiều biến độc lập không cần thiết hoặc không có ý nghĩa thống kê.
Nhìn chung, cả R bình phương và R bình phương hiệu chỉnh đều phản ánh mức độ phù hợp của mô hình hồi quy với dữ liệu thực tế. Giá trị của các chỉ số này càng tiến gần 1 thì khả năng giải thích của mô hình càng cao; ngược lại, giá trị càng gần 0 cho thấy mô hình có mức độ phù hợp thấp và khả năng giải thích hạn chế.
2. R bình phương hiệu chỉnh nhỏ hơn 0,5 (50%)
Quan điểm cho rằng hệ số R bình phương phải đạt từ 0,5 trở lên, tương ứng với việc các biến độc lập trong mô hình hồi quy giải thích ít nhất 50% sự biến thiên của biến phụ thuộc, là một cách hiểu chưa chính xác về ý nghĩa của chỉ tiêu này.
Trong thực tiễn nghiên cứu, không tồn tại một ngưỡng chuẩn chung quy định giá trị R bình phương hoặc R bình phương hiệu chỉnh ở mức bao nhiêu thì mô hình hồi quy được xem là đạt yêu cầu. Mức độ chấp nhận của hai chỉ tiêu này phụ thuộc vào nhiều yếu tố khác nhau, bao gồm:
- Thứ nhất, lĩnh vực nghiên cứu. Trong một số lĩnh vực khoa học xã hội hoặc hành vi, giá trị R bình phương trên 0,3 đã được xem là tương đối tốt, trong khi ở các lĩnh vực kỹ thuật hoặc khoa học tự nhiên, mô hình thường chỉ được chấp nhận khi R bình phương đạt mức rất cao, thậm chí trên 0,9.
- Thứ hai, mục tiêu của nghiên cứu. Khi nghiên cứu hướng đến mục tiêu dự báo, giá trị R bình phương cao có ý nghĩa quan trọng nhằm đảm bảo độ chính xác của mô hình. Ngược lại, trong các nghiên cứu tập trung vào việc phân tích và giải thích mối quan hệ giữa các biến, R bình phương không nhất thiết phải ở mức cao.
- Thứ ba, mức độ phức tạp của mô hình. Mô hình hồi quy có số lượng biến độc lập càng nhiều thì giá trị R bình phương càng có xu hướng tăng. Tuy nhiên, sự gia tăng này không đồng nghĩa với việc mô hình có chất lượng tốt hơn hay phù hợp hơn về mặt lý thuyết.
3. Cách nâng cao giá trị R bình phương và R bình phương hiệu chỉnh trong SPSS
Một trong những kỹ thuật thường được sử dụng nhằm cải thiện giá trị R bình phương và R bình phương hiệu chỉnh là xem xét và loại bỏ các điểm dị biệt, hay còn gọi là các giá trị ngoại lai, trong kết quả phân tích hồi quy, khi những điểm này không phản ánh đúng đặc điểm chung của tổng thể nghiên cứu.
3.1 Tăng hệ số R bình phương thông qua đồ thị Scatter Plot trong phân tích hồi quy
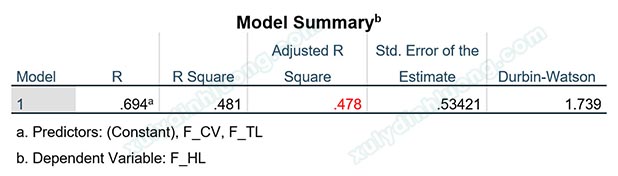
Xét ví dụ phân tích hồi quy tuyến tính bội với hai biến độc lập F_TL và F_CV tác động đến biến phụ thuộc F_HL. Kết quả trong bảng Model Summary cho thấy giá trị R bình phương hiệu chỉnh (Adjusted R Square) đạt 0.478. Chỉ số này phản ánh mức độ giải thích của mô hình hồi quy đối với sự biến thiên của biến phụ thuộc; giá trị càng tiệm cận 1 thì mức độ phù hợp của mô hình càng cao.

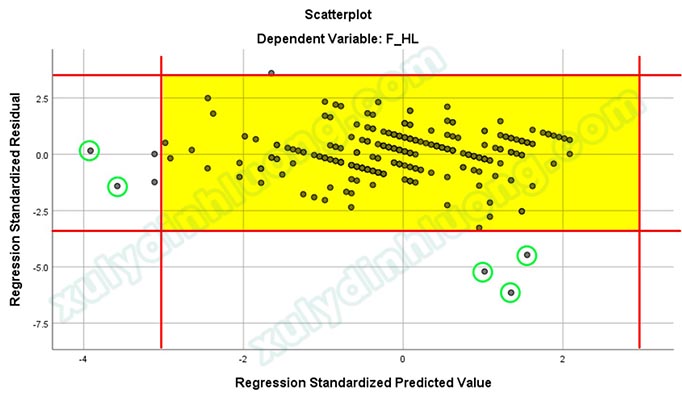
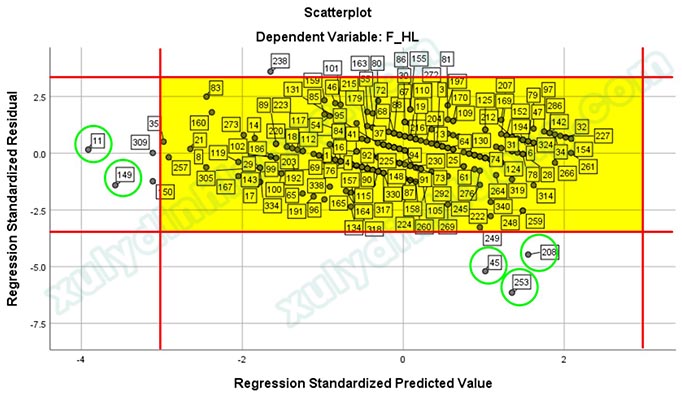
Để xây dựng đồ thị Scatter Plot trong SPSS khi thực hiện phân tích hồi quy tuyến tính bội, người nghiên cứu truy cập vào mục Plots, sau đó đưa biến ZRESID vào trục Y và biến ZPRED vào trục X. Đồ thị này cho phép quan sát mối quan hệ giữa phần dư chuẩn hóa và giá trị dự đoán chuẩn hóa của mô hình.

Việc thực hiện đúng quy trình phân tích hồi quy tuyến tính bội là cần thiết nhằm đảm bảo xuất đầy đủ các bảng kết quả và đồ thị phục vụ cho việc đánh giá và diễn giải mô hình, trong đó bao gồm cả đồ thị Scatter Plot dùng để kiểm tra các giả định của hồi quy.

Theo quy luật thực nghiệm Empirical Rule, còn gọi là quy luật 68-95-99.7 trong phân phối chuẩn, các quan sát nằm ngoài khoảng từ -3 đến 3 trên cả trục hoành và trục tung được xem là các điểm dị biệt. Những điểm này có thể ảnh hưởng tiêu cực đến chất lượng mô hình hồi quy. Trong trường hợp kết quả hồi quy chưa đạt mức độ phù hợp mong muốn, việc xem xét loại bỏ các điểm dị biệt là cần thiết. Trên đồ thị Scatter Plot, có năm điểm được đánh dấu nằm ngoài vùng trung tâm, được xác định là các quan sát dị biệt.

Để xác định cụ thể các quan sát này, có thể yêu cầu SPSS hiển thị nhãn của từng điểm dữ liệu bằng cách nhấp đúp chuột vào đồ thị, lựa chọn công cụ hiển thị nhãn quan sát, sau đó đóng cửa sổ chỉnh sửa.

Kết quả cho thấy năm điểm dị biệt tương ứng với các quan sát có số thứ tự 11, 149, 45, 208 và 253.

Tiếp theo, tiến hành loại bỏ năm quan sát trên khỏi bộ dữ liệu. Để đảm bảo thao tác chính xác, cần tạo một biến đánh số thứ tự cho các quan sát và thực hiện xóa theo thứ tự từ hàng có số lớn đến hàng có số nhỏ. Sau khi loại bỏ các quan sát dị biệt, tiến hành chạy lại phân tích hồi quy tuyến tính bội để đánh giá sự thay đổi của mô hình.

Kết quả cho thấy giá trị Adjusted R Square mới đạt 0.553, cao hơn đáng kể so với giá trị ban đầu là 0.478, cho thấy mức độ phù hợp của mô hình đã được cải thiện rõ rệt. Sự cải thiện này đạt được với việc loại bỏ 5 quan sát dị biệt. So với tổng cỡ mẫu là 350, số lượng quan sát bị loại là không đáng kể, do đó việc loại bỏ này được xem là hợp lý nhằm nâng cao chất lượng và độ tin cậy của kết quả hồi quy.
Trong trường hợp dữ liệu khảo sát gặp nhiều vấn đề và vi phạm các giả định của hồi quy, người nghiên cứu có thể cân nhắc sử dụng các dịch vụ hỗ trợ phân tích SPSS chuyên nghiệp để tối ưu hóa thời gian thực hiện và nâng cao chất lượng kết quả nghiên cứu.
3.2 Tăng hệ số R bình phương thông qua bảng Casewise Diagnostics
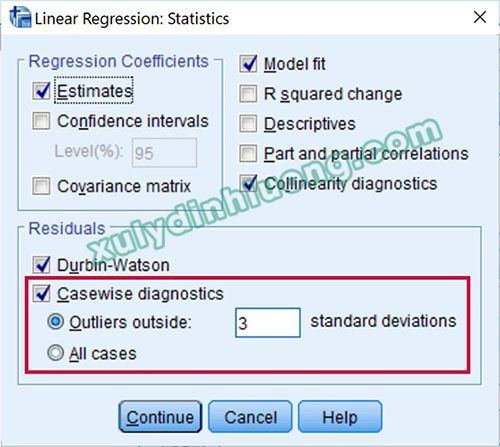
Trong phân tích hồi quy tuyến tính, phần mềm SPSS hỗ trợ chức năng tự động phát hiện các quan sát dị biệt thông qua bảng Casewise Diagnostics. Để kích hoạt chức năng này, trong hộp thoại Statistics của hồi quy, người nghiên cứu lựa chọn mục Casewise diagnostics và thiết lập ngưỡng phát hiện dị biệt tại ô Outliers outside với giá trị 2 hoặc 3 độ lệch chuẩn. Thông thường, quá trình đánh giá sẽ ưu tiên xem xét các quan sát nằm ngoài ngưỡng 3 độ lệch chuẩn trước; trong trường hợp việc xử lý các quan sát này chưa cải thiện đáng kể kết quả mô hình, khi đó mới tiếp tục xem xét các quan sát nằm ngoài ngưỡng 2 độ lệch chuẩn.

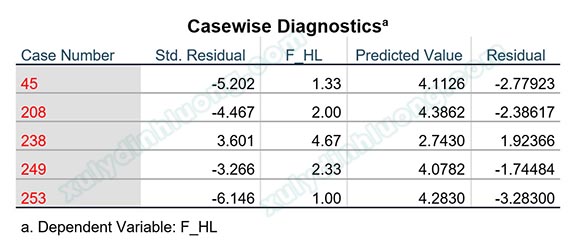
Tiếp tục thực hiện phân tích hồi quy nhằm đánh giá tác động của các biến độc lập F_TL và F_CV lên biến phụ thuộc F_HL. Trong mục Casewise diagnostics, giá trị 3 được thiết lập để xác định các quan sát dị biệt vượt quá 3 độ lệch chuẩn. Kết quả phân tích cho thấy hệ số Adjusted R Square của mô hình đạt 0.478, đồng thời bảng Casewise Diagnostics xác định các quan sát dị biệt bao gồm các trường hợp có số thứ tự 45, 208, 238, 249 và 253.

Tiến hành loại bỏ năm quan sát tương ứng với các hàng 45, 208, 238, 249 và 253 khỏi tập dữ liệu. Để đảm bảo thao tác chính xác, cần tạo một biến số thứ tự quan sát trong dữ liệu. Khi thực hiện xóa, các quan sát nên được loại bỏ theo thứ tự từ hàng có số thứ tự lớn đến hàng có số thứ tự nhỏ. Sau đó, phân tích hồi quy tuyến tính bội được thực hiện lại trên tập dữ liệu đã loại bỏ các quan sát dị biệt nhằm đánh giá sự thay đổi của mô hình.

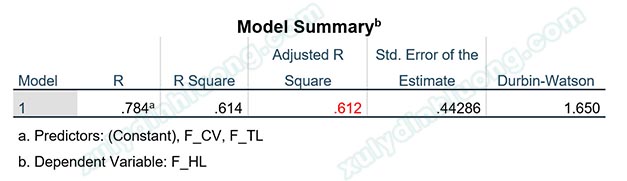
Kết quả phân tích hồi quy sau khi xử lý dữ liệu cho thấy hệ số Adjusted R Square tăng lên 0.612, cao hơn đáng kể so với giá trị ban đầu là 0.478. Điều này cho thấy mức độ phù hợp của mô hình hồi quy đã được cải thiện rõ rệt sau khi loại bỏ năm quan sát dị biệt.