Trong quá trình xử lý dữ liệu với SPSS, đặc biệt khi thực hiện các kiểm định như Independent Samples T-test, ANOVA, hồi quy tuyến tính hoặc phân tích tương quan, bạn thường bắt gặp cột Sig. hoặc Sig. (2-tailed) trong bảng kết quả. Giá trị này chính là p-value, được sử dụng để đánh giá mức độ phù hợp của dữ liệu thực nghiệm với giả thuyết nghiên cứu. Thông qua p-value, bạn xác định liệu kết quả thu được có đủ bằng chứng thống kê để bác bỏ giả thuyết gốc hay không.
1. Khái niệm cơ bản về hệ số Sig. (p-value)
Về bản chất, p-value là xác suất quan sát được giá trị thống kê kiểm định ít nhất cực đoan như giá trị thực tế, với giả định rằng giả thuyết gốc H₀ là đúng. Nói cách khác, p-value phản ánh xác suất sai lầm loại I khi bạn quyết định bác bỏ H₀ trong khi trên thực tế H₀ đúng.
Giá trị này dao động trong khoảng từ 0 đến 1.
- Khi p-value (hay Sig.) có giá trị nhỏ, điều đó cho thấy xác suất xảy ra sai lầm khi bác bỏ H₀ là thấp, từ đó cung cấp bằng chứng thống kê ủng hộ việc bác bỏ giả thuyết gốc.
- Ngược lại, nếu p-value lớn, dữ liệu chưa cung cấp đủ cơ sở để bác bỏ H₀, và kết quả kiểm định được xem là không có ý nghĩa thống kê.
Trong thực hành nghiên cứu, bạn thường so sánh Sig. với mức ý nghĩa α được xác định trước, phổ biến nhất là 0,05.
- Nếu Sig. ≤ 0,05, bạn bác bỏ H₀ và kết luận rằng kết quả có ý nghĩa thống kê ở mức 5%.
- Nếu Sig. > 0,05, bạn không bác bỏ H₀, đồng nghĩa với việc chưa tìm thấy bằng chứng thống kê đủ mạnh để khẳng định sự khác biệt hay mối quan hệ trong tổng thể nghiên cứu.
Cần lưu ý rằng một số phần mềm phân tích khác như AMOS, SmartPLS hoặc Stata thường sử dụng trực tiếp ký hiệu p-value trong bảng kết quả. Trong khi đó, SPSS trình bày dưới dạng Sig. Một số bảng trong SPSS hiển thị Sig. (2-tailed) hoặc Sig. (1-tailed) để phân biệt kiểm định hai phía và một phía. Trường hợp chỉ ghi Sig. mà không kèm chú thích, thông thường đó được hiểu là giá trị Sig. (2-tailed).
2. Phân biệt Sig. (2-tailed) và Sig. (1-tailed)
Trong các bảng kết quả phân tích của SPSS, ngoài chỉ số Sig. thông thường, bạn có thể bắt gặp hai dạng thể hiện cụ thể hơn là Sig. (2-tailed) và Sig. (1-tailed). Hai chỉ số này đều phản ánh giá trị p trong kiểm định giả thuyết thống kê, nhưng khác nhau về định hướng của giả thuyết thay thế và cách xác định vùng bác bỏ giả thuyết không.
a. Sig. (2-tailed) – Kiểm định hai phía
Sig. (2-tailed) được sử dụng khi giả thuyết thay thế H₁ không xác định chiều tác động. Nghĩa là bạn chỉ quan tâm đến việc có sự khác biệt hoặc có mối tương quan tồn tại, nhưng không đặt ra kỳ vọng cụ thể về hướng tăng hay giảm.
Ví dụ trong kiểm định sự khác biệt trung bình giữa hai nhóm độc lập:
H₀: μ₁ = μ₂
H₁: μ₁ ≠ μ₂
Trong trường hợp này, vùng bác bỏ giả thuyết không được phân bổ ở cả hai phía của phân phối xác suất, vì chênh lệch có thể xảy ra theo hướng lớn hơn hoặc nhỏ hơn. Do đó, bạn sử dụng Sig. (2-tailed) để đánh giá ý nghĩa thống kê.
Trong thực hành nghiên cứu, kiểm định hai phía được sử dụng phổ biến hơn vì đảm bảo tính khách quan, hạn chế sai lệch do giả định trước về chiều hướng tác động, đồng thời phù hợp với đa số thiết kế nghiên cứu khám phá và kiểm định sự khác biệt tổng quát.
b. Sig. (1-tailed) – Kiểm định một phía
Sig. (1-tailed) được áp dụng khi giả thuyết thay thế H₁ xác định rõ hướng tác động. Khi đó, bạn chỉ quan tâm đến một phía của phân phối xác suất, chẳng hạn kiểm định xem một nhóm có giá trị trung bình lớn hơn nhóm còn lại hoặc một biến có tương quan dương thay vì âm.
Ví dụ trong kiểm định trung bình giữa hai nhóm:
H₀: μ₁ ≤ μ₂
H₁: μ₁ > μ₂
Trong tình huống này, vùng bác bỏ giả thuyết không chỉ nằm ở một phía của phân phối. Vì chỉ xét một đuôi của phân phối chuẩn, giá trị Sig. (1-tailed) về mặt lý thuyết sẽ bằng một nửa Sig. (2-tailed) nếu thống kê kiểm định và dữ liệu không thay đổi.
Tuy nhiên, kiểm định một phía chỉ nên được sử dụng khi bạn có cơ sở lý thuyết hoặc bằng chứng thực nghiệm rõ ràng để xác định trước hướng giả thuyết, nhằm đảm bảo tính chặt chẽ và hợp lệ của suy luận thống kê.
Trong phân tích thống kê suy luận, kiểm định một phía thường có ưu thế về mặt lực kiểm định khi giả thuyết nghiên cứu được xác định đúng hướng ngay từ đầu. Cụ thể, khi bạn dự đoán chính xác chiều tác động của biến độc lập lên biến phụ thuộc, xác suất phát hiện sự khác biệt thực sự sẽ cao hơn so với kiểm định hai phía. Tuy nhiên, nếu giả định về hướng tác động không chính xác, kiểm định một phía có thể làm gia tăng nguy cơ sai lệch kết luận do toàn bộ mức ý nghĩa được phân bổ vào một vùng bác bỏ duy nhất. Vì vậy, việc lựa chọn loại kiểm định cần dựa trên cơ sở lý thuyết, bằng chứng thực nghiệm trước đó và mục tiêu nghiên cứu cụ thể.
Bảng dưới đây trình bày sự khác biệt giữa kiểm định một phía và kiểm định hai phía theo các tiêu chí học thuật cơ bản:
| Đặc điểm | Sig. (1-tailed) | Sig. (2-tailed) |
| Hướng giả thuyết | Có hướng (>, <) | Không có hướng (≠) |
| Vùng kiểm định | Một phía của phân phối | Hai phía của phân phối |
| Giá trị p | Bằng một nửa giá trị p của kiểm định hai phía (khi cùng thống kê kiểm định) | Gấp đôi giá trị p của kiểm định một phía |
| Mức độ chặt chẽ | Mức độ nghiêm ngặt thấp hơn do toàn bộ mức ý nghĩa tập trung vào một phía | Mức độ nghiêm ngặt cao hơn do mức ý nghĩa được chia cho hai phía |
| Ứng dụng trong SPSS | Sử dụng khi giả thuyết nghiên cứu có định hướng rõ ràng | Thiết lập mặc định và được sử dụng phổ biến |
3. Hệ số Sig. trong các phân tích cụ thể của SPSS
a. Kiểm định T-Test
Trong phân tích định lượng bằng SPSS, Paired-Sample T Test là một kiểm định thống kê tham số được sử dụng nhằm so sánh giá trị trung bình của cùng một nhóm đối tượng tại hai thời điểm khác nhau hoặc dưới hai điều kiện đo lường khác nhau. Phương pháp này thường được áp dụng trong các nghiên cứu thực nghiệm trước – sau hoặc các thiết kế lặp lại trên cùng một mẫu.
Giả thuyết H₀: Không tồn tại sự khác biệt về giá trị trung bình giữa hai lần khảo sát.
Giả thuyết H₁: Tồn tại sự khác biệt về giá trị trung bình giữa hai lần khảo sát.
Hệ số Sig., hay còn gọi là p-value, là xác suất quan sát được kết quả kiểm định khi giả thuyết không H₀ là đúng. Đây là căn cứ quan trọng để bạn đưa ra quyết định thống kê. Nếu giá trị Sig. nhỏ hơn mức ý nghĩa lựa chọn (thường là 0.05), bạn bác bỏ giả thuyết H₀.
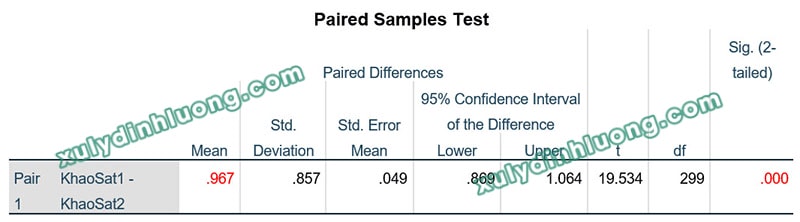
Trong bảng Paired Samples Test, giá trị Sig. = 0.000 < 0.05, do đó bạn bác bỏ giả thuyết H₀. Kết quả này cho thấy tồn tại sự khác biệt có ý nghĩa thống kê giữa giá trị trung bình của hai biến KhaoSat1 và KhaoSat2.
b. Phân tích tương quan Pearson Correlation
Phân tích tương quan Pearson được sử dụng để đánh giá mức độ và chiều hướng của mối quan hệ tuyến tính giữa hai biến định lượng. Hệ số tương quan Pearson (r) phản ánh cường độ tương quan, trong khi hệ số Sig. kiểm định ý nghĩa thống kê của mối quan hệ này.
Xét mối tương quan giữa hai biến F_LD và F_HL:
Giả thuyết H₀: Không tồn tại mối tương quan tuyến tính giữa F_LD và F_HL.
Giả thuyết H₁: Tồn tại mối tương quan tuyến tính giữa F_LD và F_HL.
Hệ số Sig. hay p-value trong phân tích tương quan thể hiện xác suất để quan sát được hệ số tương quan mẫu khi trong tổng thể thực sự không có tương quan. Nếu Sig. nhỏ hơn 0.05, bạn có đủ bằng chứng thống kê để bác bỏ giả thuyết H₀.
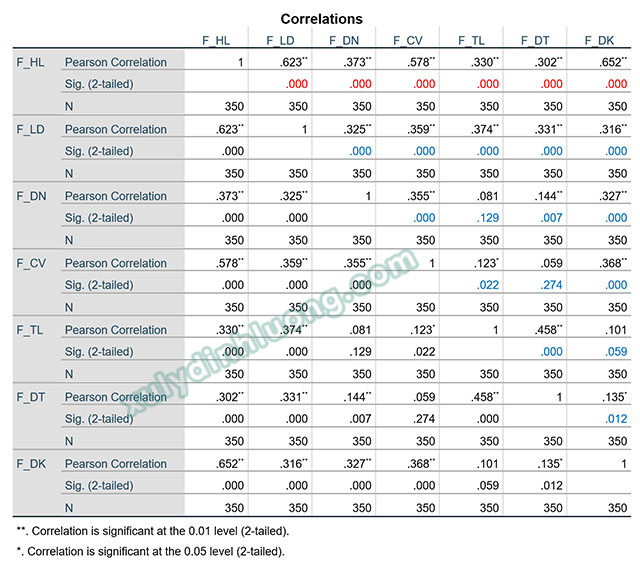
Trong bảng Correlation, giá trị Sig. của cặp biến F_LD và F_HL bằng 0.000 < 0.05. Vì vậy, bạn bác bỏ giả thuyết H₀ và kết luận rằng giữa F_LD và F_HL tồn tại mối tương quan tuyến tính có ý nghĩa thống kê.
c. Phân tích hồi quy Regression
Trong mô hình hồi quy tuyến tính, một trong những mục tiêu trọng tâm là đánh giá mức độ tác động của các biến độc lập lên biến phụ thuộc. Hệ số Sig. trong bảng Coefficients được sử dụng để kiểm định ý nghĩa thống kê của từng hệ số hồi quy riêng lẻ.
Xét tác động của biến độc lập F_DN lên biến phụ thuộc F_HL:
Giả thuyết H₀: Biến F_DN không có tác động đến F_HL.
Giả thuyết H₁: Biến F_DN có tác động đến F_HL.
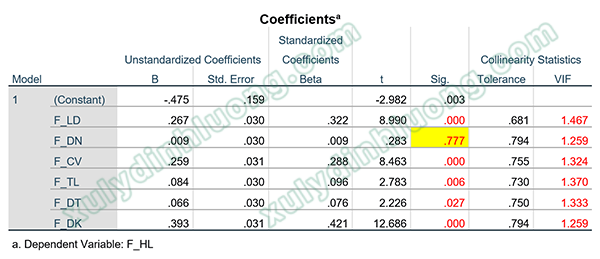
Hệ số Sig. hay p-value tại bảng Coefficients phản ánh xác suất quan sát được hệ số hồi quy khi trong tổng thể hệ số này thực sự bằng 0. Nếu Sig. nhỏ hơn mức ý nghĩa 0.05, bạn bác bỏ giả thuyết H₀ và kết luận biến độc lập có ảnh hưởng đến biến phụ thuộc.
Trong trường hợp này, giá trị Sig. của F_DN bằng 0.777 > 0.05. Do đó, bạn không có đủ cơ sở thống kê để bác bỏ giả thuyết H₀. Kết luận cho thấy F_DN không có tác động có ý nghĩa thống kê đến F_HL trong mô hình hồi quy đã xây dựng.
4. Các mức diễn giải phổ biến của p-value (Sig.) trong SPSS
Trong phân tích định lượng bằng SPSS, giá trị p-value (ký hiệu Sig.) được sử dụng để đánh giá mức ý nghĩa thống kê của kiểm định. Các ngưỡng ý nghĩa thường được quy ước như sau:
| Giá trị p-value | Mức ý nghĩa | Diễn giải |
| Sig. < 0.001 | *** | Có ý nghĩa thống kê rất cao (mức tin cậy 99,9%) |
| Sig. < 0.01 | ** | Có ý nghĩa thống kê ở mức 99% |
| Sig. < 0.05 | * | Có ý nghĩa thống kê ở mức 95% |
| Sig. ≥ 0.05 | Không có ý nghĩa thống kê |
Trong mọi kiểm định giả thuyết, bạn luôn bắt đầu với hai giả thuyết đối lập:
- H₀ (giả thuyết không): Không tồn tại sự khác biệt giữa các nhóm hoặc không có mối quan hệ giữa các biến trong tổng thể.
- H₁ (giả thuyết đối): Tồn tại sự khác biệt giữa các nhóm hoặc có mối quan hệ giữa các biến trong tổng thể.
Phần mềm SPSS tính toán giá trị p-value nhằm hỗ trợ bạn đưa ra quyết định thống kê giữa hai giả thuyết này dựa trên mức ý nghĩa đã lựa chọn trước đó (thường là 0,05).
Nếu Sig. < 0.05: bạn bác bỏ H₀ và chấp nhận H₁, kết luận rằng kết quả có ý nghĩa thống kê.
Nếu Sig. ≥ 0.05: bạn không bác bỏ H₀, nghĩa là chưa có đủ bằng chứng thống kê để khẳng định sự khác biệt hoặc mối quan hệ tồn tại trong tổng thể.
Cần lưu ý rằng p-value không phản ánh mức độ mạnh hay yếu của tác động, mà chỉ cho biết liệu bằng chứng thống kê có đủ để khẳng định sự tồn tại của tác động hay không.