Khi đọc và diễn giải kết quả phân tích trên phần mềm SMARTPLS 4, bạn cần tuân thủ nghiêm ngặt quy trình hai giai đoạn theo chuẩn mực của phương pháp PLS-SEM. Đây là yêu cầu mang tính nguyên tắc trong nghiên cứu mô hình cấu trúc tuyến tính dựa trên phương sai.
Giai đoạn thứ nhất là đánh giá mô hình đo lường (Measurement Model). Ở bước này, bạn kiểm định chất lượng thang đo thông qua các tiêu chí về độ tin cậy, giá trị hội tụ và giá trị phân biệt. Mục tiêu là xác nhận rằng các biến quan sát đo lường chính xác và nhất quán các biến tiềm ẩn mà bạn xây dựng trong mô hình.
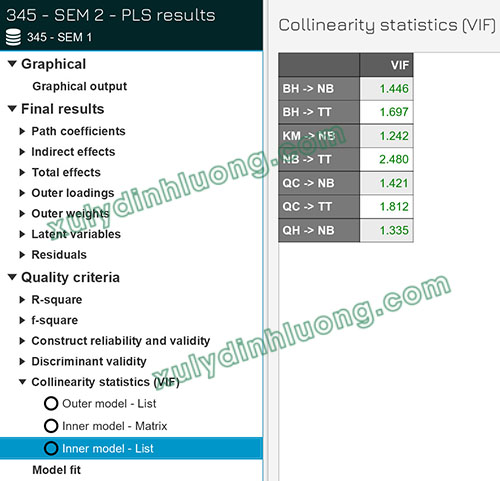
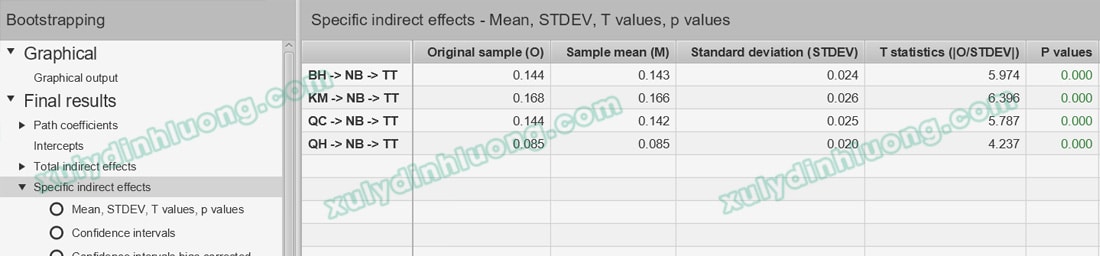
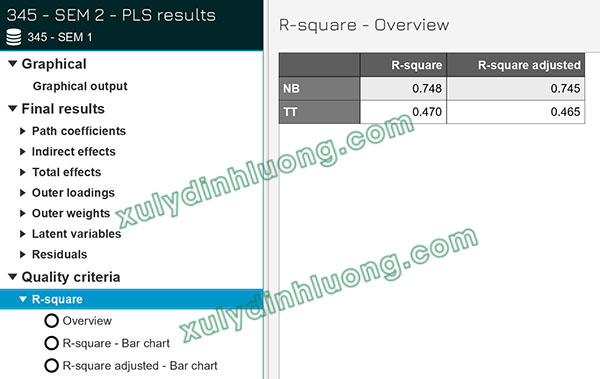
Giai đoạn thứ hai là đánh giá mô hình cấu trúc (Structural Model). Sau khi mô hình đo lường đạt yêu cầu, bạn tiếp tục kiểm định ý nghĩa thống kê của các mối quan hệ giữa các biến tiềm ẩn, mức độ giải thích của mô hình, hiện tượng đa cộng tuyến, cũng như các tác động gián tiếp, tác động điều tiết và phân tích đa nhóm (MGA) nếu có.
Hai giai đoạn này phải được thực hiện theo đúng trình tự. Bạn chỉ được phép chuyển sang đánh giá mô hình cấu trúc khi mô hình đo lường đã đạt đầy đủ các tiêu chuẩn về độ tin cậy và giá trị. Nếu thang đo không đạt yêu cầu, các kết quả ở mô hình cấu trúc sẽ thiếu cơ sở và không có ý nghĩa khoa học.
I. Cách đọc kết quả SMARTPLS 4: Mô hình đo lường (Measurement Model)
Trong giai đoạn này, bạn tập trung đánh giá độ tin cậy và giá trị của các thang đo được sử dụng để đo lường các khái niệm hay biến tiềm ẩn trong mô hình nghiên cứu. Trọng tâm của bước này là xác định liệu bộ câu hỏi được thiết kế có phản ánh đúng và đầy đủ bản chất của từng nhân tố hay không. Những biến quan sát hoặc nhân tố không đáp ứng tiêu chuẩn thống kê sẽ cần được loại bỏ trước khi tiến hành phân tích mô hình cấu trúc.
Trong phương pháp PLS-SEM, các cấu trúc tiềm ẩn có thể được đo lường theo hai dạng chính: thang đo phản ánh (reflective) và thang đo tạo thành (formative). Mỗi dạng thang đo có cơ chế đánh giá và tiêu chí kiểm định khác nhau. Nếu bạn trình bày đồng thời cả hai loại trong cùng một nội dung tổng hợp, phần phân tích có thể trở nên phức tạp và khó theo dõi về mặt logic phương pháp.
Do thang đo phản ánh được sử dụng phổ biến trong phần lớn các nghiên cứu thuộc lĩnh vực kinh tế, quản trị và khoa học xã hội, nội dung hướng dẫn đánh giá mô hình đo lường dưới đây chỉ tập trung áp dụng cho thang đo reflective.
Trong trường hợp bạn cần tìm hiểu đầy đủ quy trình đánh giá thang đo formative, bạn nên tham khảo một tài liệu chuyên biệt dành riêng cho loại thang đo này.
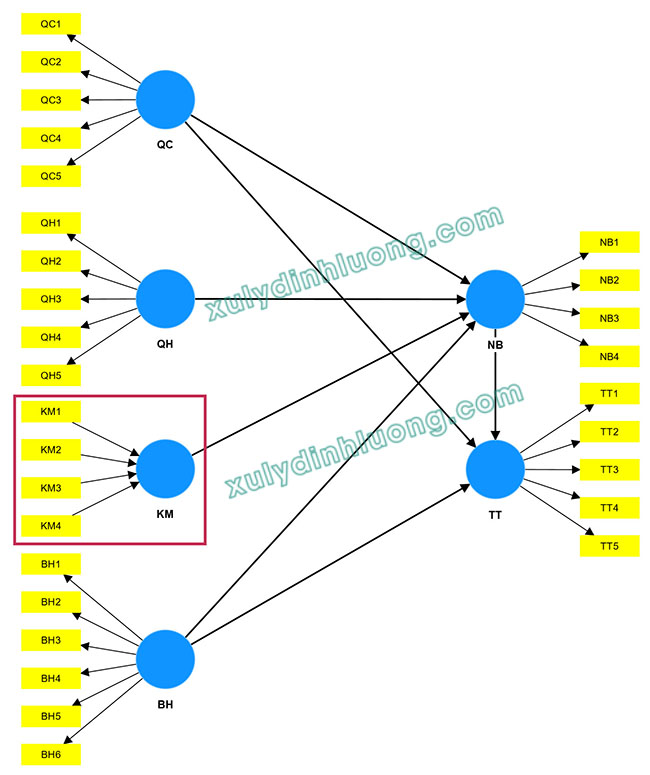
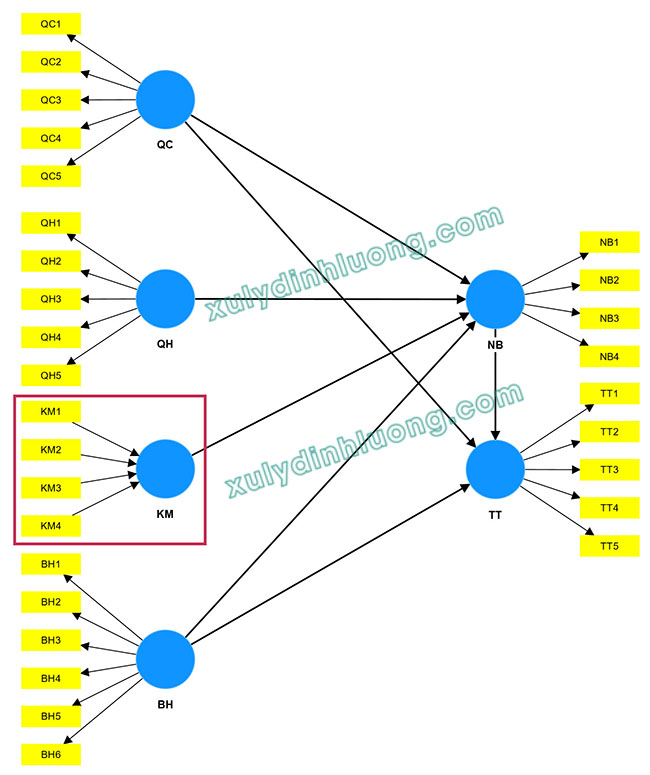
Để minh họa cụ thể cho quy trình phân tích, bạn có thể xem xét một mô hình nghiên cứu ví dụ như sau.
1. Đánh giá độ tin cậy của biến quan sát (indicator reliability)
Đánh giá độ tin cậy của các biến quan sát nhằm xác định mức độ mà từng chỉ báo phản ánh chính xác và nhất quán khái niệm tiềm ẩn trong mô hình nghiên cứu. Thông qua bước phân tích này, bạn có thể nhận diện các biến có hệ số tải thấp, cho thấy khả năng giải thích hạn chế đối với cấu trúc nhân tố, từ đó xem xét loại bỏ để nâng cao chất lượng mô hình đo lường. Việc chỉ giữ lại các biến quan sát có mức độ đại diện cao sẽ góp phần bảo đảm tính giá trị và độ tin cậy của thang đo.
Ngưỡng đánh giá thường được sử dụng trong phân tích PLS-SEM như sau:
– ≥ 0.7: Biến quan sát đạt độ tin cậy tốt và được khuyến nghị giữ lại.
– < 0.4: Biến quan sát không đạt yêu cầu và nên loại bỏ khỏi mô hình.
– Từ 0.4 đến < 0.7: Việc giữ hay loại biến cần được cân nhắc dựa trên các tiêu chí bổ sung, do đây là khoảng giá trị còn nhiều tranh luận và phụ thuộc vào quan điểm đánh giá cũng như bối cảnh nghiên cứu:
-
Trường hợp độ tin cậy tổng hợp (CR) hoặc phương sai trích trung bình (AVE) chưa đạt ngưỡng chấp nhận, nếu việc loại bỏ biến giúp cải thiện CR hoặc AVE đạt chuẩn thì nên cân nhắc loại.
-
Trường hợp CR và AVE đã đạt yêu cầu, bạn có thể giữ lại biến nếu chỉ báo đó có ý nghĩa về mặt lý thuyết và đóng góp vào nội hàm khái niệm.
Ví dụ: Trong phần mềm SmartPLS 4, sau khi chạy thuật toán PLS-SEM Algorithm, bạn chọn mục Outer Loadings để kiểm tra hệ số tải ngoài của từng biến quan sát và tiến hành đánh giá mô hình đo lường.
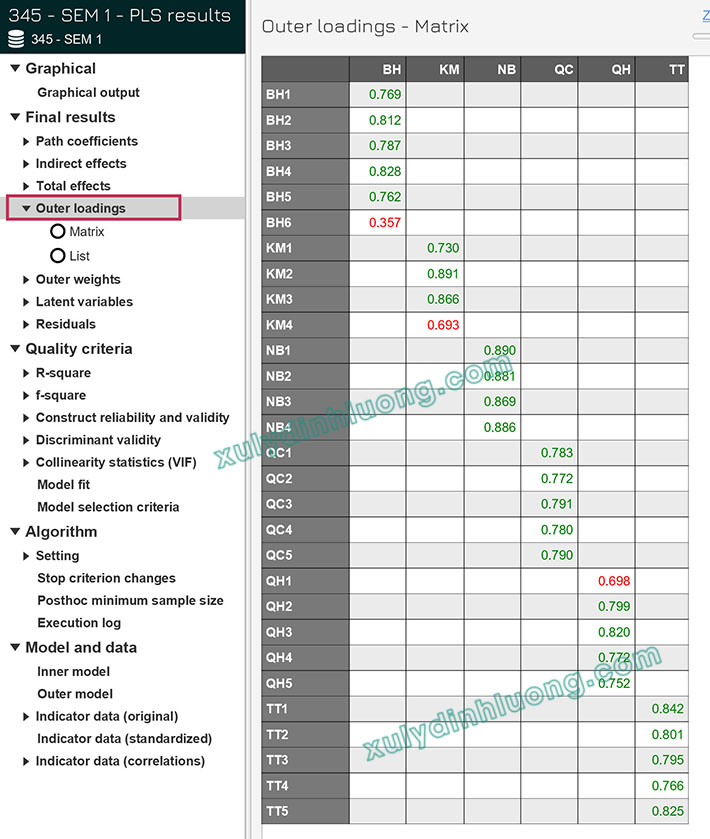
Trong nghiên cứu này, tác giả lựa chọn tiêu chí loại bỏ toàn bộ các biến quan sát có hệ số outer loading dưới 0.7 và chỉ giữ lại các biến có outer loading từ 0.7 trở lên nhằm bảo đảm tính chặt chẽ của thang đo. Kết quả phân tích cho thấy hai biến BH6 và QH1 có hệ số outer loading nhỏ hơn 0.7, do đó hai biến này được loại khỏi mô hình và tiến hành phân tích lại lần thứ hai để đánh giá lại cấu trúc đo lường.
2. Độ tin cậy thang đo (Scale Reliability)
Trong phân tích mô hình cấu trúc tuyến tính dựa trên phương pháp bình phương tối thiểu từng phần (PLS-SEM), phần mềm SmartPLS cung cấp ba chỉ số chủ yếu để đánh giá độ tin cậy nhất quán nội bộ của thang đo, bao gồm Cronbach’s Alpha, Composite Reliability rho_a và Composite Reliability rho_c.
Theo Hair và cộng sự (2022), Cronbach’s Alpha thường có xu hướng ước lượng thấp độ tin cậy thực tế của thang đo do giả định các biến quan sát có hệ số tải bằng nhau. Ngược lại, Composite Reliability rho_c lại có xu hướng đánh giá cao hơn mức độ tin cậy vì dựa trên hệ số tải thực tế của từng biến quan sát. Do đó, mức độ tin cậy thực sự của một cấu trúc tiềm ẩn thường được xem là nằm trong khoảng giữa hai giá trị này.
Trong bối cảnh đó, Composite Reliability rho_a (Dillon–Goldstein’s rho) được xem là chỉ số phản ánh độ tin cậy chính xác hơn, vì giá trị của nó thường dao động giữa Cronbach’s Alpha và rho_c, qua đó thể hiện sát hơn mức độ nhất quán nội tại của thang đo (Hair et al., 2022). Đây là điểm khác biệt quan trọng giữa rho_c và rho_a, khi rho_a được nhiều nghiên cứu khuyến nghị ưu tiên sử dụng để đánh giá độ tin cậy. Tuy nhiên, trong một số trường hợp, rho_a có thể nhạy cảm với đặc điểm dữ liệu và cho ra giá trị vượt quá 1, phản ánh khả năng tồn tại vấn đề trong bộ dữ liệu.
Ngưỡng đánh giá chung cho cả ba chỉ số độ tin cậy được đề xuất như sau:
- Giá trị từ 0,70 trở lên thể hiện thang đo đạt độ tin cậy tốt;
- Từ 0,60 đến dưới 0,70 có thể được chấp nhận trong các nghiên cứu mang tính khám phá;
- Giá trị vượt quá 0,95 cho thấy nguy cơ trùng lặp nội dung giữa các biến quan sát.
- Trường hợp chỉ số mang giá trị âm hoặc lớn hơn 1 thường là dấu hiệu của sai sót dữ liệu hoặc vấn đề trong mô hình đo lường.
Ví dụ: Để kiểm tra độ tin cậy trong SmartPLS 4, bạn thực hiện thuật toán PLS-SEM và truy cập mục Construct Reliability and Validity trong phần kết quả.
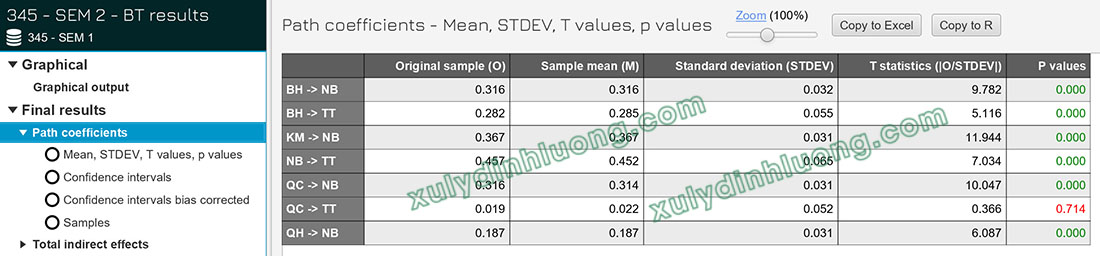
Kết quả phân tích cho thấy toàn bộ các cấu trúc nhân tố đều đạt độ tin cậy thỏa mãn yêu cầu khi cả Cronbach’s Alpha và Composite Reliability (rho_c) đều vượt ngưỡng 0,70. Điều này chứng tỏ các biến quan sát trong từng thang đo có mức độ nhất quán nội tại cao và cùng đo lường một khái niệm tiềm ẩn một cách ổn định.
Trong trường hợp xuất hiện cấu trúc nhân tố không đạt ngưỡng độ tin cậy tối thiểu, quy trình xử lý được thực hiện theo hướng loại bỏ tuần tự các biến quan sát có hệ số tải ngoài thấp nhất. Sau mỗi lần loại biến, bạn tiến hành chạy lại phân tích PLS-SEM để đánh giá lại các chỉ số độ tin cậy. Quy trình này được lặp lại cho đến khi cấu trúc nhân tố đạt mức độ tin cậy theo yêu cầu thì dừng.
Nếu sau quá trình tinh chỉnh, thang đo vẫn còn tối thiểu hai biến quan sát và đáp ứng ngưỡng độ tin cậy, có thể kết luận cấu trúc nhân tố đạt yêu cầu về độ tin cậy. Ngược lại, nếu số biến quan sát giảm xuống còn hai mà thang đo vẫn không đạt ngưỡng tối thiểu, cấu trúc nhân tố đó được xem là không đảm bảo độ tin cậy và cần cân nhắc loại bỏ khỏi mô hình nghiên cứu. Trong một số trường hợp đặc biệt, thang đo có thể chỉ gồm một biến quan sát, tuy nhiên việc này chỉ nên được chấp nhận một cách hạn chế và phải có cơ sở lý luận vững chắc.
3. Tính hội tụ của thang đo (Convergent Validity)
Để đánh giá tính hội tụ của thang đo trong mô hình PLS-SEM trên phần mềm SmartPLS, bạn cần xem xét chỉ số phương sai trích trung bình AVE (Average Variance Extracted). Theo Hock và Ringle (2010), một thang đo được xem là đạt giá trị hội tụ khi AVE lớn hơn hoặc bằng 0,50. Ngưỡng 0,50 hàm ý rằng biến tiềm ẩn có khả năng giải thích tối thiểu 50% phương sai của các biến quan sát thuộc cùng một khái niệm. Nói cách khác, mức độ chia sẻ phương sai giữa biến tiềm ẩn và các biến quan sát phải đạt từ trung bình trở lên để đảm bảo tính hội tụ.
Ngưỡng đánh giá được xác định như sau:
- AVE ≥ 0,50: thang đo đạt tính hội tụ.
Trong trường hợp dữ liệu thu thập chưa đảm bảo chất lượng, có thể phát sinh các vấn đề như vi phạm độ tin cậy, không đạt tính hội tụ hoặc phân biệt, hoặc số lượng biến quan sát bị loại bỏ quá nhiều làm suy giảm giá trị đo lường của thang đo. Khi đó, bạn nên cân nhắc tìm kiếm sự hỗ trợ chuyên môn trong phân tích PLS-SEM để rà soát và điều chỉnh mô hình phù hợp.
Ví dụ, sau khi chạy thuật toán PLS-SEM (PLS Algorithm), bạn truy cập mục Construct Reliability and Validity và quan sát cột AVE trong bảng kết quả của mô hình đo lường trên SmartPLS phiên bản 4.
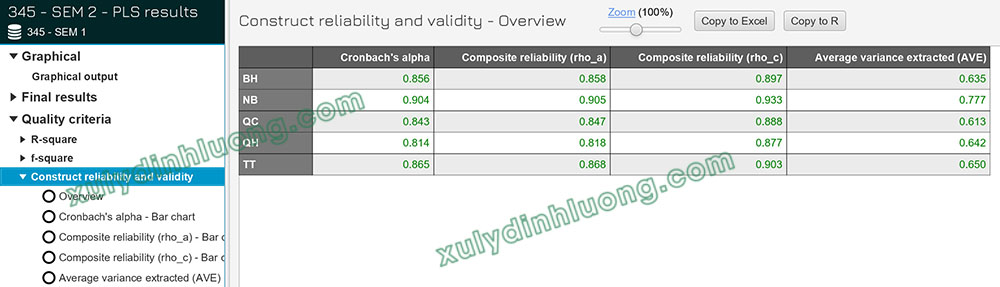
Nếu tất cả các cấu trúc đều có AVE ≥ 0,50, có thể kết luận rằng các thang đo trong mô hình đều đạt tính hội tụ theo tiêu chuẩn đề xuất.
Trường hợp một thang đo có AVE nhỏ hơn 0,50, bạn tiến hành loại bỏ lần lượt các biến quan sát có hệ số tải ngoài (outer loading) thấp nhất nhằm cải thiện giá trị AVE. Quy trình này được thực hiện theo hướng lặp, nghĩa là sau mỗi lần loại biến, bạn chạy lại mô hình và kiểm tra lại AVE cho đến khi đạt ngưỡng yêu cầu.
Sau khi điều chỉnh, nếu thang đo vẫn còn tối thiểu hai biến quan sát và AVE đạt từ 0,50 trở lên, có thể kết luận rằng thang đo đáp ứng yêu cầu về tính hội tụ.
Ngược lại, nếu thang đo chỉ còn hai biến quan sát nhưng AVE vẫn nhỏ hơn 0,50, khi đó thang đo không đạt tính hội tụ và cần được loại bỏ khỏi mô hình nghiên cứu để đảm bảo tính chặt chẽ và độ tin cậy của kết quả phân tích.
4. Tính phân biệt của thang đo (Discriminant Validity)
Tính phân biệt được sử dụng để xác nhận rằng mỗi cấu trúc tiềm ẩn trong mô hình là một khái niệm riêng biệt và không trùng lặp về nội dung đo lường với các cấu trúc khác. Một thang đo đạt yêu cầu về tính phân biệt khi các biến quan sát của nó phản ánh đúng và duy nhất khái niệm cần đo, thay vì đồng thời đại diện cho một cấu trúc khác trong mô hình.
Khi tính phân biệt không được đảm bảo, bạn không thể khẳng định các cấu trúc là độc lập về mặt khái niệm. Điều này có thể dẫn đến sai lệch trong ước lượng các hệ số của mô hình cấu trúc, làm suy giảm độ tin cậy của kết quả và hạn chế giá trị giải thích của nghiên cứu.
Trong SmartPLS 4, tính phân biệt thường được đánh giá thông qua hai phương pháp chủ yếu sau:
a. Tiêu chí Fornell và Larcker
Theo tiêu chí Fornell và Larcker, tính phân biệt được xác lập khi căn bậc hai của phương sai trích trung bình (AVE) của một cấu trúc lớn hơn tất cả các hệ số tương quan giữa cấu trúc đó với các cấu trúc còn lại trong mô hình. Nguyên tắc này dựa trên lập luận rằng một cấu trúc phải chia sẻ phương sai với các biến quan sát của chính nó nhiều hơn so với phương sai chia sẻ với các cấu trúc khác.
Ngưỡng đánh giá được xác định như sau:
- Nếu căn bậc hai AVE lớn hơn toàn bộ các hệ số tương quan trong cùng hàng hoặc cột, cấu trúc đạt tính phân biệt.
- Nếu tồn tại bất kỳ hệ số tương quan nào lớn hơn hoặc bằng căn bậc hai AVE, tính phân biệt bị vi phạm.
Ví dụ: Trong SmartPLS 4, bạn thực hiện kiểm tra bằng cách chạy PLS-SEM Algorithm, sau đó chọn mục Discriminant Validity và chọn Fornell-Larcker Criterion.
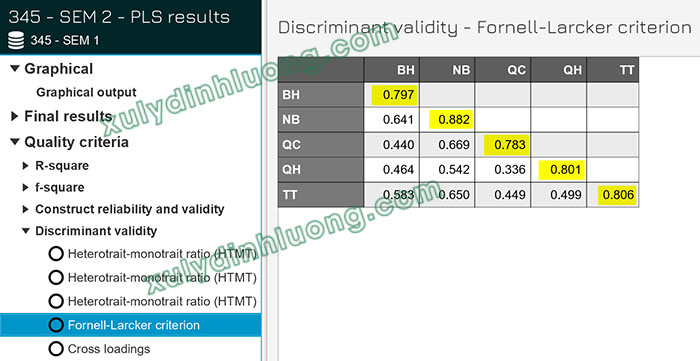
Trong bảng kết quả, các giá trị trên đường chéo chính là căn bậc hai AVE của từng cấu trúc, còn các giá trị ngoài đường chéo thể hiện hệ số tương quan giữa các cấu trúc.
Khi diễn giải kết quả, bạn so sánh hệ số tương quan giữa hai cấu trúc với căn bậc hai AVE của từng cấu trúc trong cặp đó.
- Nếu hệ số tương quan nhỏ hơn cả hai giá trị căn bậc hai AVE, cặp cấu trúc đạt tính phân biệt.
- Ngược lại, nếu hệ số tương quan lớn hơn hoặc bằng một trong hai giá trị này, tính phân biệt không được đảm bảo.
Ví dụ minh họa:
Giả sử hệ số tương quan giữa BH và NB là 0.641;
Căn bậc hai AVE của BH là 0.797
Và của NB là 0.882.
Do 0.641 nhỏ hơn cả 0.797 và 0.882 nên hai cấu trúc này đạt yêu cầu về tính phân biệt.
Kết quả thực nghiệm cho thấy toàn bộ các cấu trúc trong mô hình đều đáp ứng tiêu chí Fornell và Larcker vì không có hệ số tương quan nào vượt quá giá trị căn bậc hai AVE tương ứng.
b. Chỉ số HTMT (Heterotrait–Monotrait Ratio)
Các nghiên cứu gần đây, đặc biệt là của Henseler và cộng sự (2015), đã chỉ ra những hạn chế nhất định của các phương pháp truyền thống trong phát hiện vi phạm tính phân biệt. Nhóm tác giả đề xuất sử dụng chỉ số HTMT để đánh giá tính phân biệt một cách chặt chẽ hơn.
HTMT được tính bằng tỷ lệ giữa trung bình các tương quan khác đặc tính (heterotrait-heteromethod) và trung bình các tương quan cùng đặc tính (monotrait-heteromethod). Nếu hai cấu trúc thực sự khác biệt về mặt khái niệm, giá trị HTMT phải ở mức thấp.
Ngưỡng đánh giá thường được áp dụng:
- HTMT nhỏ hơn 0.85 cho thấy tính phân biệt rõ ràng.
- HTMT nhỏ hơn 0.90 cho thấy tính phân biệt được chấp nhận.
- HTMT từ 0.90 trở lên phản ánh vi phạm nghiêm trọng tính phân biệt.
Ví dụ: Trong SmartPLS 4, bạn chọn Discriminant Validity và tiếp tục chọn Heterotrait-Monotrait Ratio (HTMT) – Matrix để xem ma trận giá trị HTMT.
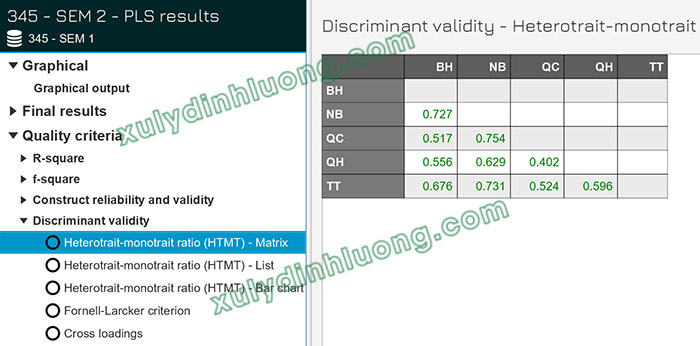
Kết quả thực hành cho thấy toàn bộ các giá trị HTMT đều nhỏ hơn 0.90, do đó mô hình đảm bảo tính phân biệt theo tiêu chí này.
Xử lý trường hợp vi phạm tính phân biệt
Khi phát hiện vi phạm, bạn cần tiến hành các bước kiểm tra và điều chỉnh sau:
- Thứ nhất, xem xét giá trị HTMT để đánh giá mức độ vi phạm; nếu HTMT lớn hơn hoặc bằng 0.90, hai cấu trúc có thể không đủ khác biệt về mặt khái niệm.
- Thứ hai, kiểm tra bảng cross-loading để xác định các biến quan sát có biểu hiện tải chéo cao, đặc biệt là những biến có outer loading thấp hoặc có hệ số tải vào cấu trúc khác xấp xỉ với cấu trúc gốc.
- Thứ ba, loại bỏ từng biến quan sát có vấn đề và chạy lại mô hình, đồng thời đánh giá lại HTMT và tiêu chí Fornell–Larcker sau mỗi lần điều chỉnh.
- Nếu việc loại biến không cải thiện tình hình, bạn cần rà soát lại nội dung thang đo vì có khả năng hai cấu trúc đang đo lường những khía cạnh quá tương đồng.
- Trong trường hợp lý thuyết cho phép và bản chất hai cấu trúc thực sự đại diện cho cùng một khái niệm, bạn có thể xem xét gộp chúng thành một cấu trúc duy nhất.
- Nếu vẫn cần duy trì hai cấu trúc riêng biệt, bạn có thể cân nhắc sử dụng mô hình bậc cao nhằm giảm mức độ tương quan giữa các cấu trúc thành phần.
- Cuối cùng, nếu tất cả các biện pháp trên không mang lại cải thiện, bạn cần xem xét lại mô hình lý thuyết hoặc cấu trúc thang đo ban đầu để đảm bảo tính chặt chẽ và nhất quán về mặt học thuật.