Phân tích nhân tố khẳng định (Confirmatory Factor Analysis – CFA) được thực hiện trên phần mềm AMOS là một bước then chốt trong quá trình kiểm định mô hình đo lường, nhằm đánh giá mức độ phù hợp giữa dữ liệu quan sát thu thập được và cấu trúc lý thuyết đã được xây dựng từ trước. Phương pháp này cho phép kiểm định mối quan hệ giữa các biến quan sát và các khái niệm tiềm ẩn mà chúng đại diện, qua đó xác nhận tính hợp lý của mô hình đo lường trong nghiên cứu.
Mục lục
1. Mục đích của phân tích nhân tố khẳng định CFA
Phân tích nhân tố khẳng định (Confirmatory Factor Analysis – CFA) là một kỹ thuật thống kê được sử dụng nhằm phục vụ các mục tiêu sau:
a. Kiểm định mô hình đo lường
Khác với phân tích nhân tố khám phá (Exploratory Factor Analysis – EFA), CFA không nhằm mục đích phát hiện cấu trúc nhân tố mới mà tập trung kiểm định cấu trúc nhân tố đã được xác định dựa trên cơ sở lý thuyết hoặc các nghiên cứu trước đó.
CFA được sử dụng để xác nhận liệu các biến quan sát, chẳng hạn như các câu hỏi trong bảng khảo sát hoặc các chỉ báo đo lường, có phản ánh đúng và đầy đủ các khái niệm hay cấu trúc tiềm ẩn mà chúng được thiết kế để đo lường hay không.
b. Đánh giá mức độ phù hợp của mô hình
Một trong những mục tiêu trọng tâm của CFA là đánh giá mức độ phù hợp của mô hình lý thuyết đề xuất với dữ liệu thực nghiệm thu thập được.
Phân tích CFA cung cấp nhiều chỉ số đánh giá độ phù hợp của mô hình như Chi-square, CMIN/df, GFI, CFI, TLI, RMSEA, PCLOSE và SRMR, qua đó cho phép xem xét mức độ tương thích giữa cấu trúc lý thuyết và cấu trúc dữ liệu thực tế. Khi các chỉ số này đạt ngưỡng chấp nhận, có thể kết luận rằng mô hình lý thuyết phản ánh tương đối chính xác mối quan hệ giữa các biến trong tập dữ liệu nghiên cứu.
c. Đánh giá chất lượng của thang đo
CFA đóng vai trò quan trọng trong việc kiểm tra độ tin cậy và giá trị của các thang đo được sử dụng trong nghiên cứu.
Độ tin cậy được đánh giá nhằm xác định mức độ nhất quán nội tại của các biến quan sát khi cùng đo lường một nhân tố tiềm ẩn, trong đó chỉ số độ tin cậy tổng hợp (Composite Reliability – CR) thường được sử dụng.
Giá trị hội tụ phản ánh mức độ mà các biến quan sát thuộc cùng một nhân tố thực sự đo lường chung một khái niệm, thường được đánh giá thông qua chỉ số phương sai trích trung bình (Average Variance Extracted – AVE).
Giá trị phân biệt được sử dụng để xác định mức độ độc lập giữa các nhân tố trong mô hình, nhằm đảm bảo rằng các cấu trúc tiềm ẩn không bị trùng lặp và đại diện cho những khái niệm khác nhau. Việc đánh giá giá trị phân biệt thường được thực hiện thông qua so sánh chỉ số phương sai chia sẻ tối đa (MSV) với AVE, hoặc sử dụng các tiêu chí như bảng Fornell–Larcker và chỉ số HTMT.
2. Những hiểu lầm phổ biến về phân tích CFA
Hiểu lầm 1: Bắt buộc phải thực hiện EFA trước khi tiến hành CFA
Trong nhiều nghiên cứu định lượng hiện nay, quy trình phân tích thường được triển khai theo trình tự Cronbach’s Alpha → EFA → CFA → SEM. Cách tiếp cận này dần hình thành một quan điểm khá phổ biến rằng mọi nghiên cứu đều cần thực hiện EFA trước khi tiến hành CFA. Tuy nhiên, cách hiểu này chưa phản ánh đầy đủ bản chất phương pháp và không phải lúc nào cũng phù hợp. Việc lựa chọn EFA hay CFA phụ thuộc chủ yếu vào mục tiêu nghiên cứu và mức độ hoàn thiện của cơ sở lý thuyết ban đầu.
EFA (Exploratory Factor Analysis) là phương pháp phân tích được sử dụng nhằm khám phá cấu trúc nhân tố tiềm ẩn của bộ dữ liệu trong trường hợp nhà nghiên cứu chưa có giả định lý thuyết rõ ràng về số lượng nhân tố cũng như mối quan hệ giữa các biến quan sát và các nhân tố đó. Ngược lại, CFA (Confirmatory Factor Analysis) được sử dụng để kiểm định mức độ phù hợp của một mô hình đo lường đã được xác định trước dựa trên cơ sở lý thuyết hoặc các nghiên cứu trước đó.
Trong trường hợp mô hình lý thuyết đã được xây dựng rõ ràng và các thang đo đã được kiểm chứng trong bối cảnh nghiên cứu tương tự, nhà nghiên cứu không nhất thiết phải thực hiện EFA mà có thể trực tiếp tiến hành phân tích theo quy trình Cronbach’s Alpha → CFA → SEM. Ngược lại, khi cơ sở lý thuyết chưa vững chắc hoặc thang đo được xây dựng mới, EFA có thể được sử dụng như một bước thăm dò trước khi tiến hành CFA và SEM.
Việc nhận thức đúng vai trò của EFA và CFA giúp lựa chọn phương pháp phân tích phù hợp, đồng thời tránh thực hiện những bước không cần thiết trong quy trình nghiên cứu.
Hiểu lầm 2: Cần có ma trận xoay từ EFA mới có thể xây dựng mô hình CFA hoặc SEM
Trong một số tài liệu hướng dẫn hoặc video về phân tích CFA, người học thường thấy tác giả sử dụng plugin Pattern Matrix Builder để tạo sơ đồ CFA dựa trên ma trận xoay thu được từ phân tích EFA. Từ đó, không ít người cho rằng việc thực hiện EFA và thu được ma trận xoay là điều kiện bắt buộc để có thể vẽ và ước lượng mô hình CFA hoặc SEM.
Trên thực tế, quan điểm này là không chính xác. Phần mềm AMOS đã cung cấp đầy đủ các công cụ cho phép nhà nghiên cứu trực tiếp xây dựng và ước lượng mô hình CFA hoặc SEM dựa trên mô hình lý thuyết đã xác định, mà không cần phụ thuộc vào kết quả EFA hay bất kỳ plugin hỗ trợ nào. Việc sử dụng plugin Pattern Matrix Builder chủ yếu nhằm tự động hóa thao tác vẽ sơ đồ và tiết kiệm thời gian, chứ không phải là yêu cầu bắt buộc về mặt phương pháp luận. Trong trường hợp không thực hiện EFA hoặc không có sẵn plugin, nhà nghiên cứu vẫn có thể vẽ thủ công mô hình CFA hoặc SEM và tiến hành phân tích dữ liệu một cách đầy đủ và hợp lệ.
3. Phương pháp phân tích nhân tố khẳng định (CFA) trên phần mềm AMOS
Phần nội dung sau đây trình bày quy trình phân tích nhân tố khẳng định dựa trên một mô hình minh họa cụ thể nhằm hướng dẫn cách đọc và diễn giải kết quả CFA trên phần mềm AMOS.
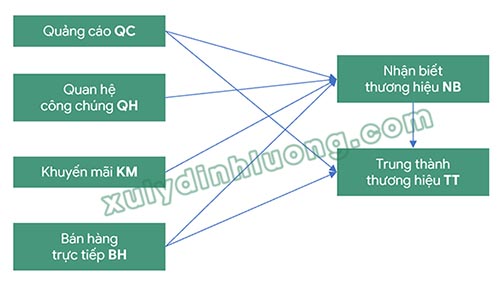
Cấu trúc các biến trong mô hình nghiên cứu bao gồm:
Nhân tố QC được đo lường bởi 5 biến quan sát.
Nhân tố QH được đo lường bởi 5 biến quan sát.
Nhân tố KM gồm 4 biến quan sát.
Nhân tố BH ban đầu gồm 6 biến quan sát, trong đó biến BH6 đã bị loại bỏ ở bước kiểm định độ tin cậy Cronbach’s Alpha nên không được sử dụng trong phân tích CFA.
Nhân tố NB gồm 4 biến quan sát.
Nhân tố TT gồm 5 biến quan sát.
Bước 1: Khai báo dữ liệu SPSS và xây dựng sơ đồ CFA trên AMOS
Trước khi tiến hành phân tích CFA, dữ liệu cần được khai báo từ tệp SPSS vào phần mềm AMOS và mô hình đo lường phải được thiết lập thông qua sơ đồ diagram. Quy trình thực hiện các thao tác này đã được trình bày chi tiết trong bài viết Cách sử dụng AMOS để vẽ diagram CFA, SEM. Trong trường hợp chưa nắm rõ các bước khởi tạo ban đầu, người nghiên cứu cần tham khảo lại tài liệu này trước khi tiếp tục các nội dung tiếp theo.
Một số chỉ số đánh giá mức độ phù hợp của mô hình thường được sử dụng trong phân tích CFA bao gồm:
Chi-square ký hiệu là CMIN; bậc tự do ký hiệu là DF.
Tỷ lệ Chi-square trên bậc tự do được ký hiệu là CMIN/DF.
Các chỉ số phù hợp tuyệt đối và gia tăng gồm GFI, CFI và TLI.
Chỉ số sai số xấp xỉ trung bình bình phương gốc được ký hiệu là RMSEA.
Chỉ số PCLOSE dùng để kiểm định mức độ phù hợp gần đúng của mô hình.
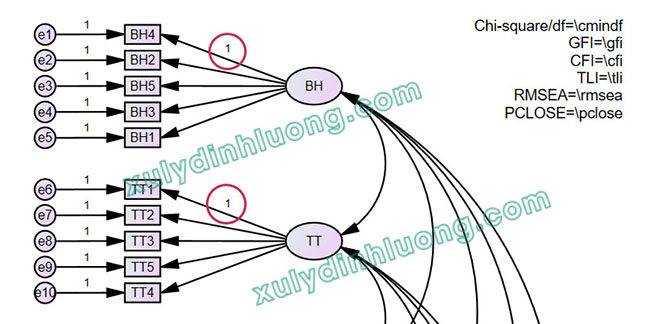
Trong phần minh họa này, tệp dữ liệu DATA AMOS.sav đã được sử dụng lại để thực hiện phân tích CFA. Sau khi hoàn tất việc vẽ và khai báo mô hình đo lường, sơ đồ CFA sẽ thể hiện đầy đủ mối quan hệ giữa các nhân tố tiềm ẩn và các biến quan sát tương ứng.
Bước 2: Thiết lập các tùy chọn phân tích CFA
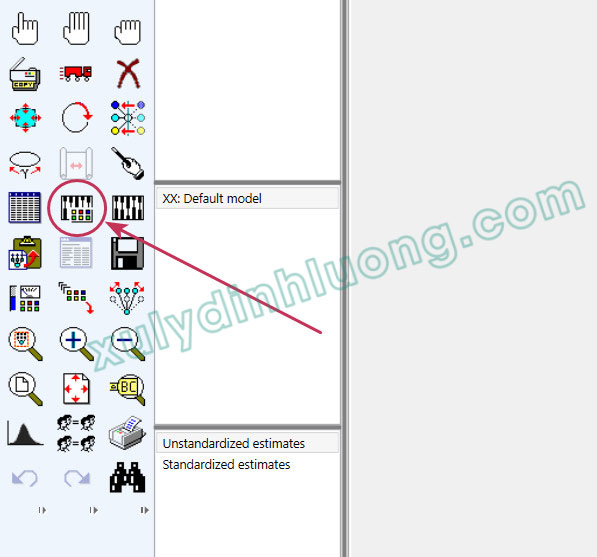
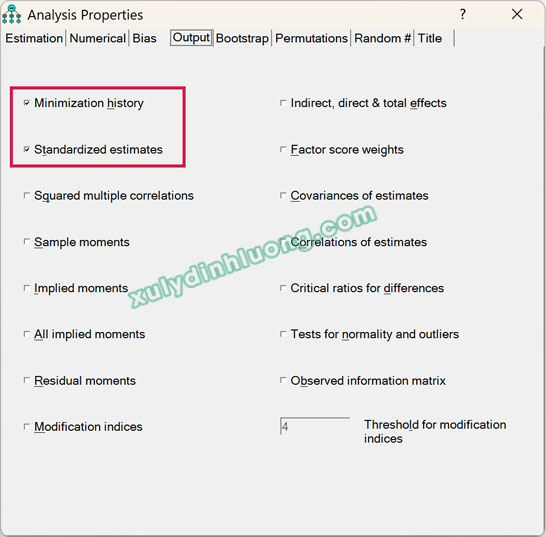
Từ giao diện chính của phần mềm AMOS, người nghiên cứu chọn mục Analysis Properties để thiết lập các tham số phân tích CFA.
Trong thẻ Output, cần lựa chọn các tùy chọn phù hợp nhằm phục vụ cho việc đánh giá và diễn giải kết quả phân tích.
Một số tùy chọn quan trọng cần được kích hoạt bao gồm:
– Standardized estimates nhằm hiển thị các hệ số ước lượng chuẩn hóa.
– Squared multiple correlations nhằm cung cấp hệ số xác định R bình phương của các biến quan sát.
– Residual moments dùng để hiển thị các phần dư của mô hình.
– Modification indices nhằm cung cấp chỉ số MI, hỗ trợ phát hiện các mối quan hệ tiềm năng có thể cải thiện mức độ phù hợp của mô hình. Việc sử dụng chỉ số này cần được thực hiện thận trọng và đã được trình bày chi tiết trong tài liệu hướng dẫn về Modification Indices trong AMOS.
Sau khi hoàn tất việc lựa chọn các tùy chọn cần thiết, người nghiên cứu xác nhận và thoát khỏi cửa sổ cài đặt để quay lại giao diện chính.
Bước 3: Thực hiện phân tích CFA
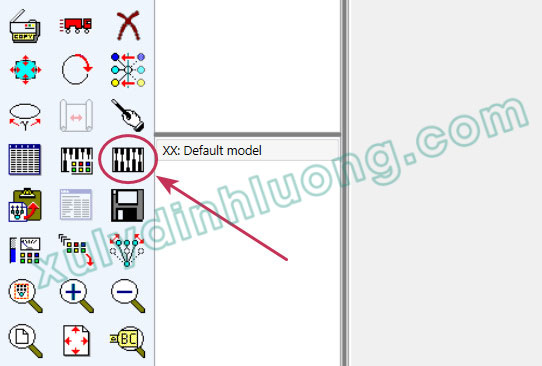
Để tiến hành phân tích nhân tố khẳng định, người nghiên cứu chọn biểu tượng Calculate Estimates trên thanh công cụ của AMOS. Phần mềm sẽ thực hiện ước lượng mô hình và hiển thị các kết quả cơ bản trực tiếp trên sơ đồ CFA.
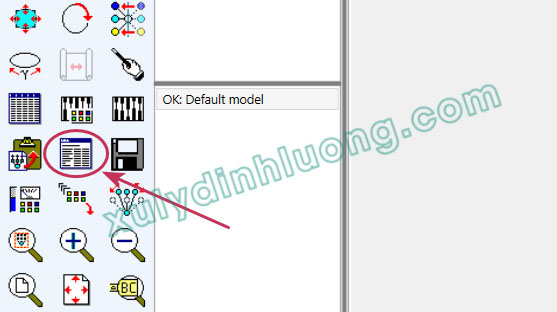
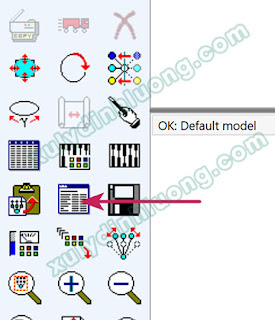
Ngoài các chỉ số được thể hiện trên diagram, người nghiên cứu cần chọn mục View Text để xem toàn bộ kết quả chi tiết của phân tích CFA, bao gồm các bảng ước lượng, chỉ số phù hợp mô hình và các thông số thống kê liên quan, phục vụ cho việc đánh giá và diễn giải kết quả nghiên cứu.
4. Đọc kết quả phân tích CFA trên AMOS
Kết quả phân tích CFA được xem xét thông qua các nhóm tiêu chí chính bao gồm: mức độ phù hợp tổng thể của mô hình, ý nghĩa thống kê của các biến quan sát, độ tin cậy của thang đo, giá trị hội tụ và giá trị phân biệt của các cấu trúc nhân tố.
4.1 Độ phù hợp mô hình (model fit)
Phân tích nhân tố khẳng định (Confirmatory Factor Analysis – CFA) được sử dụng nhằm kiểm định mức độ phù hợp của cấu trúc nhân tố được giả định ban đầu với dữ liệu thực nghiệm. Khi các cấu trúc nhân tố được xác định là phù hợp, mô hình sẽ đạt được mức độ phù hợp tổng thể; ngược lại, nếu các cấu trúc nhân tố chưa phản ánh đúng dữ liệu, mô hình sẽ vi phạm các tiêu chí về độ phù hợp.
Đánh giá độ phù hợp mô hình thực chất là đánh giá mức độ hợp lý trong cấu trúc nội tại của từng nhân tố cũng như mối quan hệ giữa các nhân tố với nhau. Một số nguyên nhân phổ biến làm suy giảm độ phù hợp mô hình bao gồm: các biến quan sát trong cùng một nhân tố có nội dung trùng lặp, biến quan sát giải thích kém cho nhân tố tiềm ẩn, biến quan sát thuộc nhân tố này nhưng lại có tải mạnh lên nhân tố khác, hoặc tồn tại hiện tượng đa cộng tuyến giữa các nhân tố.
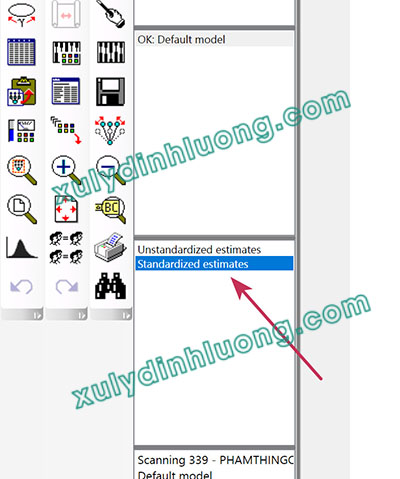
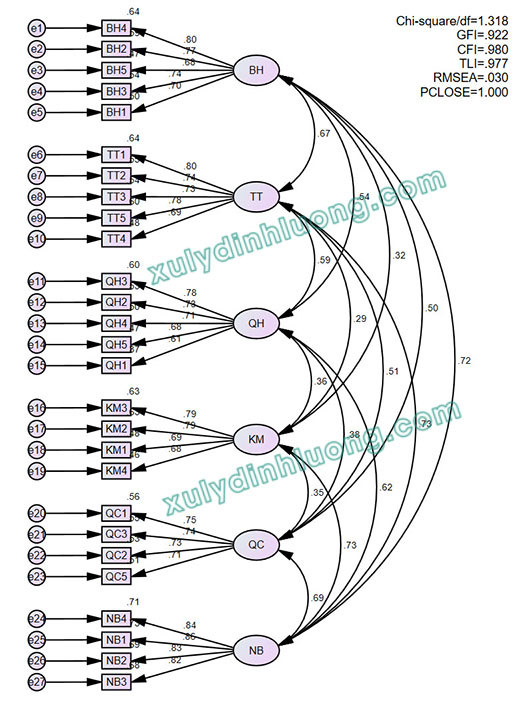
Sau khi hoàn tất quá trình ước lượng mô hình CFA, để hiển thị các hệ số chuẩn hóa trên sơ đồ mô hình, người nghiên cứu lựa chọn mục Standardized estimates trong phần thiết lập hiển thị của AMOS.
Một số chỉ số cơ bản phản ánh độ phù hợp của mô hình như Chi-square/df, GFI, CFI, TLI, RMSEA và PCLOSE thường được hiển thị trực tiếp trên phần macro chèn vào sơ đồ mô hình, cho phép người nghiên cứu có cái nhìn tổng quan và nhanh chóng về mức độ phù hợp tổng thể.
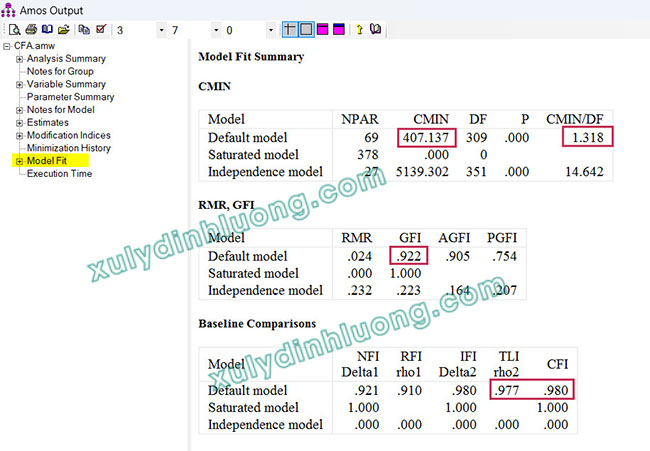
Để xem đầy đủ hơn các chỉ số đánh giá độ phù hợp mô hình, người nghiên cứu cần truy cập mục Model Fit trong phần View Text của AMOS.
Khi nhấp vào mục Model Fit ở khung bên trái, giao diện bên phải sẽ hiển thị toàn bộ các bảng thống kê liên quan đến độ phù hợp mô hình. Trong đó, chỉ số CMIN tương ứng với giá trị Chi-square của mô hình.
Theo nghiên cứu của Hu và Bentler (1999) về các tiêu chí ngưỡng đánh giá độ phù hợp trong phân tích cấu trúc hiệp phương sai, các chỉ số thường được sử dụng để đánh giá mức độ phù hợp mô hình bao gồm:
Chỉ số CMIN/df nhỏ hơn hoặc bằng 3 phản ánh mức độ phù hợp tốt, và nhỏ hơn hoặc bằng 5 được xem là chấp nhận được.
Chỉ số CFI lớn hơn hoặc bằng 0.9 được đánh giá là tốt, lớn hơn hoặc bằng 0.95 là rất tốt, trong khi giá trị từ 0.8 trở lên có thể được chấp nhận trong một số trường hợp.
Chỉ số GFI lớn hơn hoặc bằng 0.9 phản ánh mô hình phù hợp tốt, và lớn hơn hoặc bằng 0.95 là rất tốt, tuy nhiên chỉ số này cần được xem xét thận trọng. (chỉ số này bạn cần đọc thêm phần lưu ý cuối bài viết)
Chỉ số TLI lớn hơn hoặc bằng 0.9 cho thấy mô hình đạt mức phù hợp tốt.
Chỉ số RMSEA nhỏ hơn hoặc bằng 0.06 thể hiện mức độ phù hợp tốt, và nhỏ hơn hoặc bằng 0.08 được xem là chấp nhận được.
Chỉ số PCLOSE lớn hơn hoặc bằng 0.05 được đánh giá là tốt, và lớn hơn hoặc bằng 0.01 có thể chấp nhận.
Đối với trường hợp chỉ số GFI có giá trị lớn hơn 0.8 nhưng nhỏ hơn 0.9,
Cần lưu ý rằng trong nhiều nghiên cứu, đặc biệt là các nghiên cứu có cỡ mẫu hạn chế, GFI khó đạt được ngưỡng 0.9 do chỉ số này phụ thuộc mạnh vào số lượng nhân tố, số biến quan sát và quy mô mẫu. Vì lý do đó, GFI ngày càng ít được sử dụng như một tiêu chí đánh giá chính trong các nghiên cứu gần đây, và thậm chí có khuyến nghị không nên sử dụng chỉ số này (Kline, 2005; Sharma và cộng sự, 2005).
Trong trường hợp bắt buộc phải báo cáo và đánh giá GFI trong luận văn hoặc bài nghiên cứu, nếu giá trị của chỉ số này chưa đạt 0.9, người nghiên cứu có thể chấp nhận ngưỡng từ 0.8 trở lên, dựa trên các nghiên cứu của Baumgartner và Homburg (1995) cũng như Doll, Xia và Torkzadeh (1994).
Nguồn trích dẫn:
1. Baumgartner, H., Homburg, C.: Applications of Structural Equation Modeling in Marketing and Consumer Research: a review. International Journal of Research in Marketing 13(2), 139-161 (1996).
2. Doll, W.J., Xia, W., Torkzadeh, G.: A confirmatory factor analysis of the end-user computing satisfaction instrument, MIS Quarterly 18(4), 357–369 (1994).
Khi các chỉ số độ phù hợp mô hình chưa đạt được các ngưỡng chấp nhận, để cải thiện mức độ phù hợp của mô hình CFA, người nghiên cứu có thể sử dụng chỉ số Modification Indices (MI) như một công cụ hỗ trợ điều chỉnh mô hình.
4.2 Ý nghĩa của các biến quan sát (Indicator reliability)
Trong phân tích CFA, mối quan hệ giữa các biến quan sát và các nhân tố tiềm ẩn được xác định ngay từ đầu dựa trên cơ sở lý thuyết. Tuy nhiên, các mối quan hệ này cần được kiểm định lại bằng dữ liệu thực nghiệm thu thập được từ nghiên cứu nhằm đánh giá mức độ phù hợp của mô hình đo lường. Do đó, cần tiến hành xem xét liệu các biến quan sát được gán cho từng nhân tố có thực sự phản ánh tốt khái niệm tiềm ẩn tương ứng hay không.
a. Hệ số Regression Weights
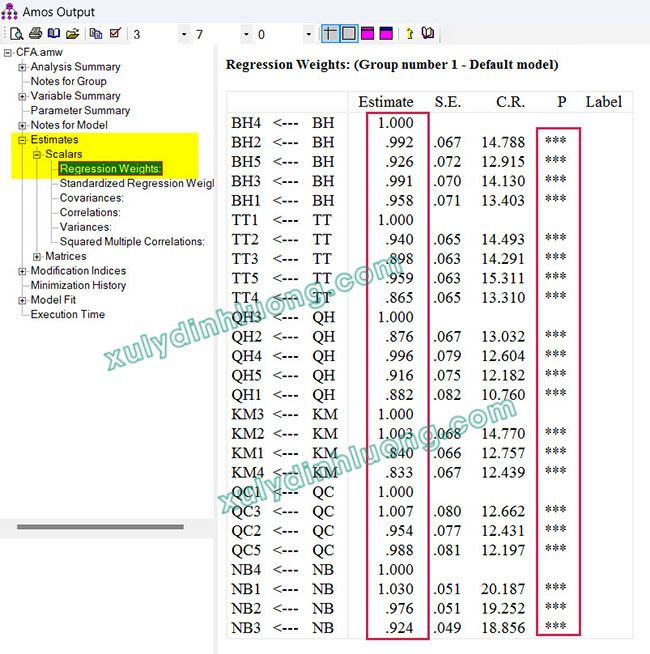
Từ giao diện Amos Output (View Text), lựa chọn Estimates > Scalars > Regression Weights để xem bảng hệ số tác động chưa chuẩn hóa, qua đó đánh giá ý nghĩa thống kê của các biến quan sát.
– Phân tích kết quả CFA trên AMOS cho thấy, cột Estimate thể hiện hệ số tác động chưa chuẩn hóa từ nhân tố tiềm ẩn đến biến quan sát. Chẳng hạn, hệ số tác động chưa chuẩn hóa từ nhân tố BH đến biến quan sát BH2 có giá trị 0.992. Một số hệ số trong cột này có giá trị bằng 1.000 do đây là các mối quan hệ tham chiếu được thiết lập trong từng nhân tố. Quan sát sơ đồ mô hình ban đầu có thể thấy các mũi tên từ BH đến BH4 hoặc từ TT đến TT1 được gán giá trị tham chiếu bằng 1 trong phần Regression Weights. Vì vậy, trong bảng kết quả, các mối quan hệ này mặc định có Estimate bằng 1.000. Việc lựa chọn biến quan sát làm biến tham chiếu trong cùng một nhân tố có thể thay đổi mà không làm ảnh hưởng đến bản chất của mô hình đo lường. Tuy nhiên, khi thay đổi biến tham chiếu, các hệ số còn lại trong cùng nhân tố sẽ thay đổi tương ứng, dẫn đến sự khác biệt về giá trị Estimate trong bảng Regression Weights, mặc dù dữ liệu và số lượng biến không thay đổi. Chính vì vậy, dù cùng một bộ dữ liệu, cùng số lượng biến đó nhưng khi khai báo quan hệ tham chiếu 1 ở mũi tên các biến quan sát khác nhau trong một nhân tố thì giá trị Estimate ở bảng này sẽ khác nhau.
– Trong bảng Regression Weights, cột C.R. thể hiện critical ratio của kiểm định ý nghĩa hệ số tác động, tương đương với giá trị t-value trong một số phần mềm thống kê khác.
– Cột P biểu thị giá trị p-value của kiểm định, tương tự chỉ số sig. Đây là cột được sử dụng chủ yếu để đánh giá ý nghĩa thống kê của các biến quan sát. Khi giá trị P nhỏ hơn 0.05, với mức ý nghĩa 5% được sử dụng trong nghiên cứu, biến quan sát được xem là có ý nghĩa trong việc giải thích nhân tố tiềm ẩn. Trong AMOS, các giá trị P bằng 0.000 được hiển thị bằng ký hiệu ***. Một số mối quan hệ không có giá trị P do chúng là các quan hệ tham chiếu trong nhân tố và mặc định có ý nghĩa thống kê. Trong trường hợp biến tham chiếu có khả năng không đạt ý nghĩa giải thích, việc đánh giá sẽ tiếp tục được thực hiện thông qua bảng hệ số chuẩn hóa.
b. Hệ số Standardized Regression Weights
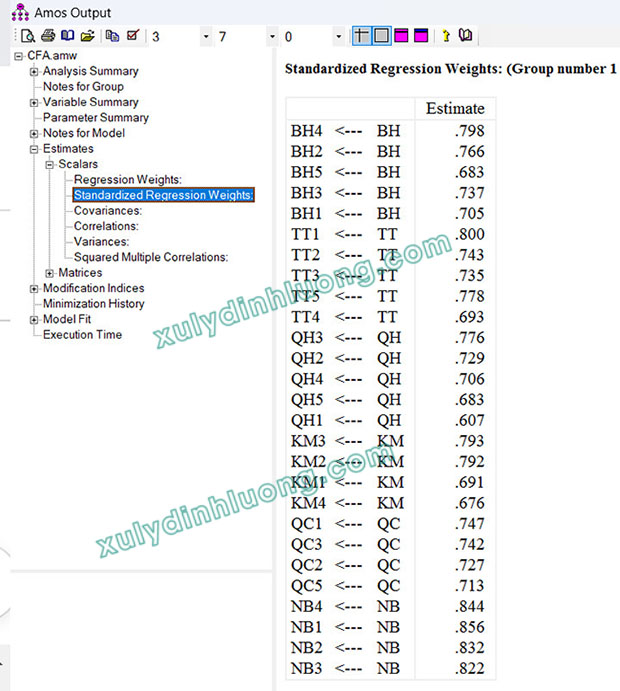
Tiếp tục từ giao diện Amos Output (View Text), lựa chọn Estimates > Scalars > Standardized Regression Weights để xem bảng hệ số tác động chuẩn hóa, nhằm đánh giá mức độ giải thích của các biến quan sát đối với nhân tố tiềm ẩn.
Theo Hair và cộng sự (2009) trong Multivariate Data Analysis, 7th Edition, Prentice Hall, Upper Saddle River, một biến quan sát được xem là có khả năng giải thích tốt cho nhân tố tiềm ẩn nếu hệ số tác động chuẩn hóa ở cột Estimate đạt giá trị từ 0.5 trở lên. Đối với bảng hệ số chuẩn hóa, việc lựa chọn biến tham chiếu trong mô hình không làm thay đổi giá trị các hệ số chuẩn hóa, do đó kết quả phản ánh ổn định mức độ đóng góp của từng biến quan sát vào nhân tố tương ứng.
4.3 Độ tin cậy, tính hội tụ và tính phân biệt của thang đo
Theo Hair và cộng sự (2010) và Hair và cộng sự (2016), việc đánh giá chất lượng thang đo trong mô hình đo lường được thực hiện thông qua các chỉ số Composite Reliability (CR), Average Variance Extracted (AVE), Maximum Shared Variance (MSV) và bảng tiêu chí Fornell và Larcker. Trong đó, CR được sử dụng để đánh giá độ tin cậy tổng hợp của thang đo, AVE phản ánh mức độ hội tụ, còn MSV và tiêu chí Fornell và Larcker được dùng để kiểm định tính phân biệt giữa các cấu trúc khái niệm.
– Độ tin cậy của thang đo được đánh giá thông qua chỉ số độ tin cậy tổng hợp. Theo khuyến nghị, giá trị CR cần đạt từ 0.7 trở lên để đảm bảo mức độ tin cậy chấp nhận được của thang đo.
– Tính hội tụ được đánh giá dựa trên phương sai trung bình được trích (AVE). Một thang đo được xem là đạt tính hội tụ khi giá trị AVE lớn hơn hoặc bằng 0.5, cho thấy các biến quan sát giải thích được phần lớn phương sai của cấu trúc tiềm ẩn.
– Tính phân biệt của thang đo được kiểm định thông qua hai tiêu chí.
Thứ nhất, phương sai chia sẻ lớn nhất (MSV) của mỗi cấu trúc cần nhỏ hơn giá trị AVE tương ứng.
Thứ hai, căn bậc hai của AVE phải lớn hơn hệ số tương quan giữa cấu trúc đó với các cấu trúc còn lại trong mô hình, theo tiêu chí Fornell và Larcker.
Phần mềm AMOS không hỗ trợ trực tiếp việc tính toán các chỉ số CR, AVE và MSV. Do đó, các chỉ số này được tính toán thông qua các công cụ bổ trợ như plugin gắn ngoài cho AMOS hoặc gói Excel Macro do James Gaskin phát triển. Do nội dung hướng dẫn cài đặt và sử dụng các công cụ này khá chi tiết, phần trình bày được tách riêng. Trong phạm vi mục này, nội dung tập trung vào cách đọc kết quả và đưa ra nhận xét.
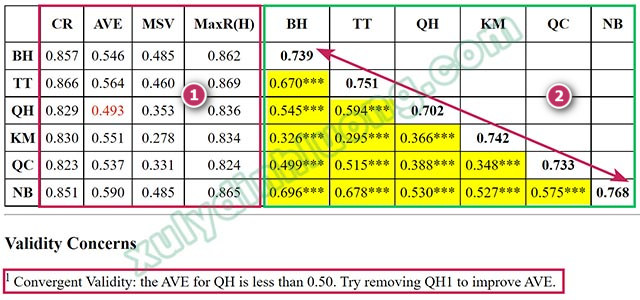
Bảng kết quả đánh giá thang đo bao gồm hai phần chính. Phần thứ nhất trình bày các chỉ số CR, AVE, MSV và MaxR(H). Phần thứ hai là bảng Fornell và Larcker thể hiện mối quan hệ tương quan giữa các cấu trúc trong mô hình.
Việc đánh giá độ tin cậy được thực hiện bằng cách xem xét giá trị CR của từng cấu trúc.
– Nếu CR lớn hơn 0.7, thang đo được xem là đạt độ tin cậy.
– Trong trường hợp CR không đạt ngưỡng yêu cầu, công cụ phân tích sẽ đưa ra cảnh báo tại mục Validity Concerns. Trong ví dụ minh họa, tất cả các nhân tố đều có giá trị CR đạt yêu cầu, do đó đảm bảo độ tin cậy.
Tính hội tụ được đánh giá thông qua giá trị AVE.
– Khi AVE lớn hơn 0.5, thang đo được xem là đạt tính hội tụ.
– Nếu AVE nhỏ hơn ngưỡng này, công cụ sẽ hiển thị cảnh báo tại mục Validity Concerns. Trong ví dụ minh họa, thang đo QH không đạt tính hội tụ do giá trị AVE nhỏ hơn 0.5. Công cụ gợi ý loại bỏ biến quan sát QH1 nhằm cải thiện giá trị AVE. Việc loại bỏ biến này có thể được thực hiện trực tiếp trên sơ đồ CFA và tiến hành phân tích lại.
Tính phân biệt được đánh giá dựa trên hai tiêu chí.
– Thứ nhất, giá trị MSV của mỗi cấu trúc cần nhỏ hơn giá trị AVE tương ứng. Khi điều kiện này được thỏa mãn, cấu trúc đạt yêu cầu về tính phân biệt.
– Thứ hai, căn bậc hai của AVE của từng cấu trúc phải lớn hơn hệ số tương quan giữa cấu trúc đó với các cấu trúc khác trong mô hình.
Trong bảng Fornell và Larcker, giá trị nằm ở đầu mỗi cột là căn bậc hai của AVE của các nhân tố, trong khi các giá trị còn lại trong cột thể hiện hệ số tương quan giữa nhân tố đó với các nhân tố khác. Ví dụ, căn bậc hai AVE của BH là 0.739, của TT là 0.751 và của QH là 0.702. Các hệ số tương quan giữa các nhân tố lần lượt là 0.670 giữa BH và TT, 0.545 giữa BH và QH, và 0.594 giữa TT và QH.
Khi phân tích kết quả, hệ số tương quan giữa một cặp cấu trúc cần nhỏ hơn giá trị căn bậc hai AVE của cả hai cấu trúc đó để đảm bảo tính phân biệt. Chẳng hạn,
Hệ số tương quan giữa BH và TT là 0.670
Trong khi căn bậc hai AVE của BH là 0.739
Và của TT là 0.751
Do hệ số tương quan nhỏ hơn cả hai giá trị này, hai cấu trúc BH và TT được xem là đạt yêu cầu về tính phân biệt.