Hồi quy nhị phân là một kỹ thuật thống kê được sử dụng nhằm mô hình hóa mối quan hệ giữa một biến phụ thuộc có dạng nhị phân (chỉ nhận hai giá trị, thường được mã hóa là 0 và 1) với một hoặc nhiều biến độc lập. Phương pháp này thường được áp dụng trong nghiên cứu để ước lượng và dự đoán xác suất xảy ra của một hiện tượng hay sự kiện dựa trên ảnh hưởng của các biến giải thích.
1. Đặc điểm của hồi quy nhị phân
Trong hồi quy nhị phân, biến phụ thuộc là biến định tính nhị phân, chẳng hạn như “có” và “không”, “thành công” và “thất bại”, hay “1” và “0”. Các dạng biến này thường đại diện cho những tình huống ra quyết định hoặc kết quả phân loại như “mua” hay “không mua”, “đậu” hay “rớt”, “có bệnh” hay “không có bệnh”.
Mô hình hồi quy nhị phân ước lượng xác suất xảy ra của biến phụ thuộc thông qua việc kết hợp tuyến tính các biến độc lập, sau đó chuyển đổi kết quả này thành xác suất. Hàm logistic (hay hàm sigmoid) được sử dụng phổ biến để đảm bảo giá trị dự đoán nằm trong khoảng từ 0 đến 1, phù hợp với ý nghĩa xác suất.
Khi biến phụ thuộc mang tính nhị phân, việc áp dụng hồi quy tuyến tính thông thường là không phù hợp do vi phạm các giả định cơ bản của mô hình. Cụ thể, phần dư của mô hình không còn tuân theo phân phối chuẩn mà có xu hướng tuân theo phân phối nhị thức. Điều này dẫn đến việc các ước lượng và kiểm định thống kê trong hồi quy tuyến tính trở nên không còn hiệu lực, do đó hồi quy nhị phân là phương pháp thay thế phù hợp hơn trong các trường hợp này.
VIDEO
2. Phương trình hồi quy nhị phân
Khác với hồi quy đa biến, trong đó mục tiêu là ước lượng giá trị của biến phụ thuộc Y dựa trên các biến độc lập X, hồi quy Binary Logistic tập trung vào việc ước lượng xác suất xảy ra của một sự kiện Y khi biết giá trị của các biến độc lập. Biến phụ thuộc Y trong mô hình này là biến nhị phân, chỉ nhận hai giá trị là 0 và 1, trong đó giá trị 0 biểu thị sự kiện không xảy ra và giá trị 1 biểu thị sự kiện xảy ra. Phương trình hồi quy nhị phân Binary Logistic được xây dựng nhằm mô tả mối quan hệ giữa xác suất xảy ra sự kiện và các biến giải thích.
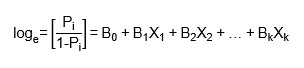
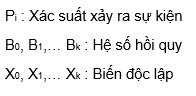
Trong đó:
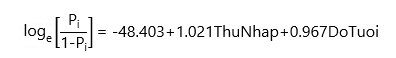
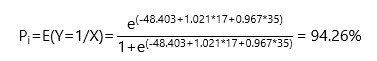
Trong hồi quy Binary Logistic thực hiện trên SPSS, mô hình không trực tiếp ước lượng xác suất mà ước lượng logit, tức là logarit tự nhiên của tỷ lệ odds. Từ phương trình hồi quy, có thể suy ra phương trình hàm dự báo xác suất xảy ra sự kiện. Đây là cơ sở quan trọng để ứng dụng mô hình vào phân tích và dự báo trong nghiên cứu thực nghiệm.
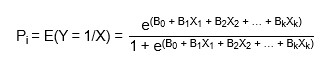
Trong đó, Pi = E(Y = 1 | X) = P(Y = 1) được hiểu là xác suất để sự kiện xảy ra (Y = 1) khi biến độc lập X nhận một giá trị cụ thể Xi. Giá trị này luôn nằm trong khoảng từ 0 đến 1 và phản ánh khả năng xảy ra của hiện tượng nghiên cứu tương ứng với từng tổ hợp giá trị của các biến độc lập.
3. Đánh giá độ phù hợp của mô hình hồi quy Binary Logistic trên SPSS
3.1 Kiểm định giả thuyết về độ phù hợp của mô hình
Trong hồi quy tuyến tính, kiểm định F thường được sử dụng để đánh giá mức độ phù hợp chung của mô hình. Tuy nhiên, đối với hồi quy Binary Logistic, kiểm định Chi-square được sử dụng thay thế nhằm kiểm định giả thuyết về sự phù hợp của mô hình hồi quy.
Cách tiếp cận của kiểm định Chi-square trong hồi quy Binary Logistic là so sánh sự khác biệt của giá trị -2 Log Likelihood (-2LL) giữa mô hình hồi quy trống (chỉ bao gồm hằng số) và mô hình hồi quy có các biến độc lập được đề xuất. Nếu mô hình đề xuất có giá trị -2LL thấp hơn đáng kể so với mô hình trống, điều này cho thấy mô hình có mức độ phù hợp tốt hơn. Trong SPSS, kết quả của mô hình hồi quy trống được thể hiện tại Block 0. Khi các biến độc lập được đưa vào mô hình, SPSS sẽ ước lượng mô hình hồi quy mới và trình bày kết quả tại Block 1, đồng thời đánh giá sự khác biệt có ý nghĩa thống kê giữa hai mô hình.
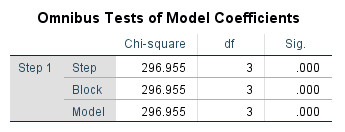
Các thông tin phục vụ cho kiểm định Chi-square được trình bày trong bảng Omnibus Tests of Model Coefficients. Bảng này bao gồm ba mục là Step, Block và Model. Trong phân tích, kết quả kiểm định Chi-square tại mục Model là trọng tâm để đánh giá độ phù hợp của mô hình. Hai mục Step và Block thường được sử dụng để phân tích bổ sung trong trường hợp áp dụng các phương pháp đưa biến vào mô hình như Forward hoặc Backward.
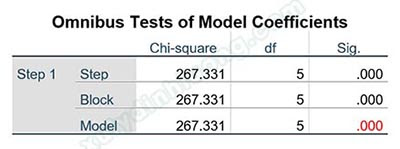
Nếu giá trị sig của kiểm định Chi-square tại dòng Model nhỏ hơn 0.05 trong trường hợp nghiên cứu sử dụng mức ý nghĩa 5%, có thể kết luận rằng mô hình hồi quy Binary Logistic là phù hợp với dữ liệu nghiên cứu. Ngược lại, nếu giá trị sig lớn hơn 0.05, mô hình được xem là không phù hợp, khi đó nhà nghiên cứu cần xem xét lại việc lựa chọn biến độc lập, cấu trúc mô hình hoặc chất lượng dữ liệu đầu vào.
3.2 Hệ số -2 Log-Likelihood (-2LL)
Giá trị -2 log-likelihood, ký hiệu là -2LL, là một chỉ số được sử dụng phổ biến trong phân tích hồi quy logistic. Chỉ số này có giá trị nhỏ nhất bằng 0 và không bị giới hạn về giá trị lớn nhất. -2LL thường được dùng để so sánh mức độ phù hợp giữa mô hình hồi quy trống (Null Model) và mô hình hồi quy được đề xuất (Proposed Model). Theo Hair và cộng sự (2014), nếu mô hình đề xuất có giá trị -2LL nhỏ hơn so với mô hình trống thì mô hình hồi quy được xem là phù hợp hơn với dữ liệu nghiên cứu.
Mô hình hồi quy trống là mô hình không đưa bất kỳ biến độc lập nào vào phân tích, trong khi mô hình hồi quy đề xuất là mô hình có sự tham gia của các biến độc lập. Tùy thuộc vào phương pháp đưa biến vào mô hình (Enter hoặc Stepwise), có thể tồn tại một hoặc nhiều mô hình hồi quy đề xuất. Tuy nhiên, trong thực hành nghiên cứu, mô hình hồi quy đề xuất cuối cùng thường được sử dụng để đánh giá và diễn giải kết quả.
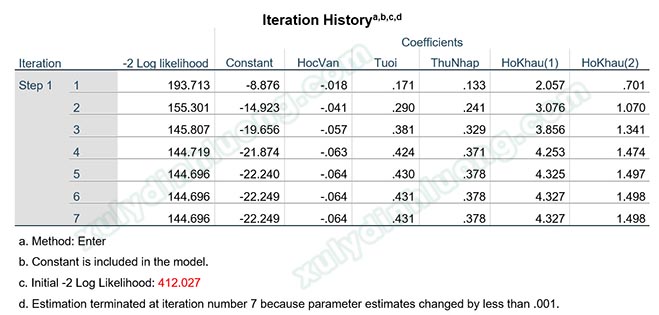
Trong phân tích hồi quy nhị phân Binary Logistic bằng phần mềm SPSS, giá trị -2LL của mô hình hồi quy trống được thể hiện dưới tên gọi Initial -2 Log Likelihood. Chẳng hạn, trong bảng kết quả minh họa, giá trị -2LL của mô hình trống là 412.027.
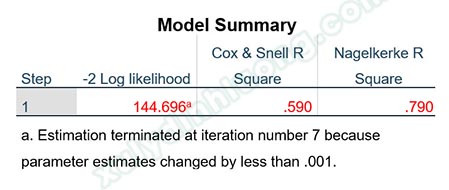
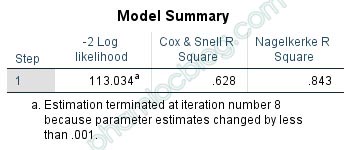
Đối với mô hình hồi quy đề xuất, giá trị -2LL được trình bày trong bảng Model Summary tại cột -2 Log Likelihood. Ví dụ, giá trị -2LL của mô hình đề xuất trong bảng kết quả là 144.696. Có thể nhận thấy rằng 144.696 nhỏ hơn 412.027, cho thấy mô hình hồi quy đề xuất có mức độ phù hợp tốt hơn so với mô hình trống.
Về mặt bản chất, việc so sánh trực tiếp giá trị -2LL giữa mô hình hồi quy trống và mô hình hồi quy đề xuất không phải là bước đánh giá bắt buộc. Nguyên nhân là do kiểm định Chi-square về độ phù hợp của mô hình đã thực hiện nội dung so sánh này và có độ chính xác cao hơn. Khi giá trị sig của kiểm định Chi-square tại hàng Model nhỏ hơn 0.05, điều này cho thấy sự khác biệt về -2LL giữa mô hình đề xuất và mô hình trống là có ý nghĩa thống kê, đồng nghĩa với việc -2LL của mô hình đề xuất đã giảm đáng kể so với mô hình trống.
3.3 Hệ số Cox & Snell R Square và Nagelkerke R Square
Kiểm định Chi-square cho phép đánh giá liệu mô hình hồi quy có phù hợp với dữ liệu hay không, tuy nhiên không phản ánh được mức độ phù hợp của mô hình là cao hay thấp. Do đó, các nhà nghiên cứu đã phát triển các chỉ số R Square giả (Pseudo R Square) dựa trên ý tưởng của hệ số R Square trong hồi quy tuyến tính nhằm đánh giá mức độ phù hợp của mô hình hồi quy nhị phân (Hair và cộng sự, 2014).
Trong phân tích hồi quy nhị phân Binary Logistic bằng SPSS, hai chỉ số R Square được sử dụng phổ biến là Cox & Snell R Square, được đề xuất bởi Cox và Snell (1989), và Nagelkerke R Square, được phát triển bởi Nagelkerke (1991). Theo công thức tính toán, hệ số Cox & Snell R Square không thể đạt tới giá trị tối đa là 1. Vì vậy, Nagelkerke đã hiệu chỉnh và đề xuất thêm một chỉ số R Square khác với giá trị dao động trong khoảng từ 0 đến 1. Cả hai chỉ số này đều được sử dụng để đánh giá mức độ phù hợp của mô hình, trong đó giá trị càng lớn thì mô hình hồi quy được xem là càng phù hợp.
Cần lưu ý rằng
- Không tồn tại một ngưỡng cụ thể để xác định giá trị R Square là cao hay thấp. Hai chỉ số R Square này càng tiến gần đến 1 thì mức độ phù hợp của mô hình càng cao.
- Ngoài ra, giá trị R Square trong hồi quy nhị phân không mang ý nghĩa tương tự như R Square trong hồi quy tuyến tính. Cụ thể, các chỉ số R Square này không phản ánh tỷ lệ biến thiên của biến phụ thuộc được giải thích bởi các biến độc lập trong mô hình hồi quy nhị phân.
3.4 Kiểm định giả thuyết về ý nghĩa của hệ số hồi quy
Trong phân tích hồi quy tuyến tính, giả thuyết về ý nghĩa của các hệ số hồi quy thường được kiểm định thông qua kiểm định t. Đối với mô hình hồi quy nhị phân Binary Logistic, việc kiểm định ý nghĩa của các hệ số hồi quy được thực hiện bằng kiểm định Wald.
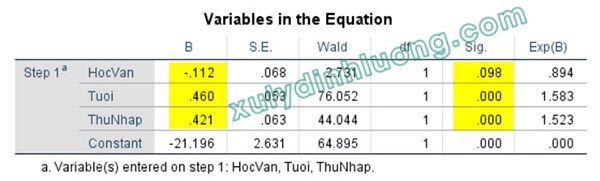
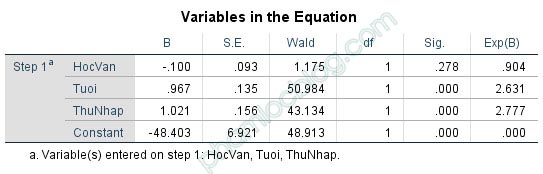
Trong mô hình hồi quy Binary Logistic được thực hiện trên phần mềm SPSS, ý nghĩa thống kê của từng biến độc lập được đánh giá dựa trên giá trị sig của kiểm định Wald. Cụ thể, khi giá trị sig của kiểm định Wald nhỏ hơn 0.05 trong trường hợp nghiên cứu sử dụng mức ý nghĩa 5%, có thể kết luận rằng biến độc lập đó có ý nghĩa thống kê và có ảnh hưởng đến biến phụ thuộc trong mô hình. Ngược lại, nếu giá trị sig lớn hơn 0.05 thì biến độc lập không có ý nghĩa thống kê.
Dấu của hệ số hồi quy B phản ánh chiều tác động của biến độc lập lên biến phụ thuộc. Khi hệ số B mang giá trị âm, biến độc lập có tác động nghịch chiều đến biến phụ thuộc; khi hệ số B mang giá trị dương, biến độc lập có tác động cùng chiều.
Trong SPSS, các thông tin liên quan đến kiểm định Wald được trình bày trong bảng Variables in the Equation. Cần lưu ý rằng, đối với những biến độc lập không đạt ý nghĩa thống kê trong mô hình hồi quy, có thể kết luận rằng các biến này không có ảnh hưởng đến biến phụ thuộc mà không nhất thiết phải loại biến và thực hiện lại quá trình hồi quy.
4. Phân tích hồi quy nhị phân Binary Logistic trên SPSS
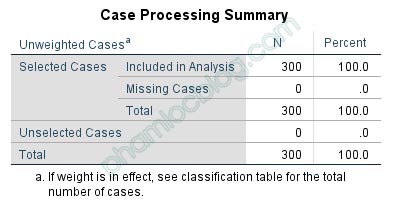
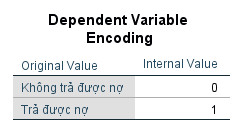
Phân tích hồi quy nhị phân Binary Logistic được minh họa thông qua một nghiên cứu của ngân hàng nhằm đánh giá khả năng trả nợ của khách hàng cá nhân, từ đó làm cơ sở cho quyết định cho vay. Trong nghiên cứu này, biến phụ thuộc TraNo là biến nhị phân với hai giá trị: giá trị 0 thể hiện khách hàng không có khả năng trả nợ và giá trị 1 thể hiện khách hàng có khả năng trả nợ.
Mô hình hồi quy bao gồm ba biến độc lập tác động đến biến phụ thuộc TraNo, bao gồm:
- Trình độ học vấn (HocVan), được đo lường bằng số năm đi học;
- Độ tuổi (Tuoi), được tính theo số tuổi tại thời điểm nghiên cứu;
- Và thu nhập hàng tháng (ThuNhap), được đo bằng mức thu nhập trung bình hàng tháng tính theo đơn vị triệu đồng.
Đối với các biến độc lập là biến định tính được phân thành các nhóm, cần tiến hành mã hóa thành các biến giả Dummy trước khi đưa vào mô hình hồi quy. Phương pháp mã hóa biến giả có thể tham khảo tại bài viết về hồi quy với biến độc lập định tính trên SPSS.
Trong trường hợp các biến độc lập được đo lường bằng thang đo bao gồm nhiều biến quan sát, cần tiến hành tính giá trị trung bình hoặc tổng các biến quan sát để tạo ra biến đại diện trước khi thực hiện phân tích hồi quy.
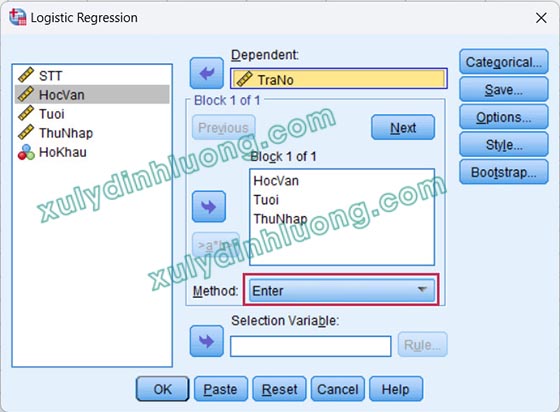
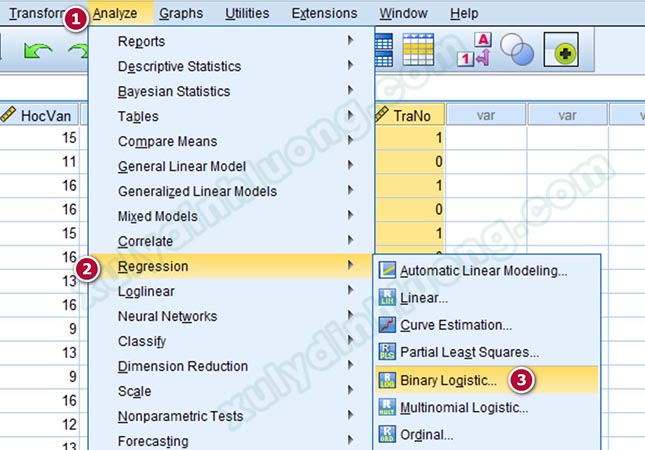
Để tiến hành hồi quy nhị phân Binary Logistic trên phần mềm SPSS, chọn Analyze > Regression > Binary Logistic.
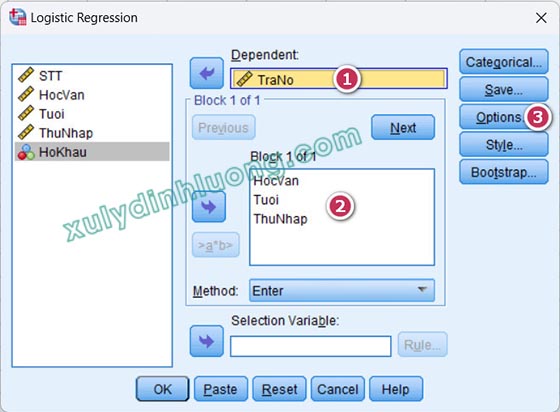
Tại cửa sổ phân tích, đưa biến phụ thuộc vào ô Dependent và các biến độc lập vào ô Covariates.
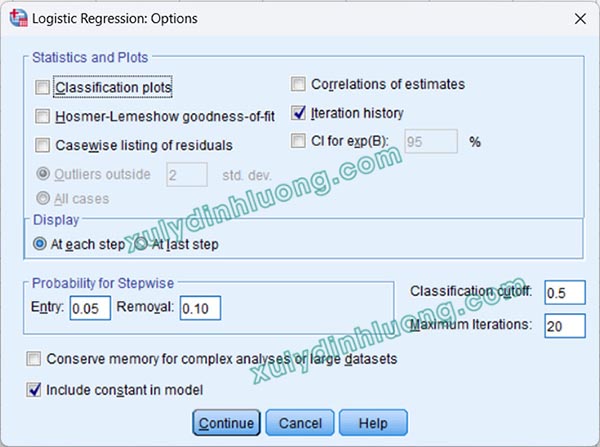
Trong mục Options, chọn Iteration history, sau đó nhấn Continue để quay lại cửa sổ chính.
Tại mục Method, lựa chọn phương pháp Enter và nhấn OK để SPSS xuất các bảng kết quả phân tích.