Phân phối chuẩn (Normal Distribution) là một giả định nền tảng trong nhiều phương pháp thống kê tham số. Khi giả định này bị vi phạm, các ước lượng và kiểm định suy luận có thể trở nên thiếu chính xác và làm giảm độ tin cậy của kết quả nghiên cứu. Vì vậy, việc đánh giá mức độ tuân thủ phân phối chuẩn của dữ liệu là một bước bắt buộc trước khi tiến hành các phân tích thống kê ở mức độ cao hơn.
Trong phần mềm SPSS, hai kiểm định thường được sử dụng để kiểm tra giả định phân phối chuẩn là Shapiro–Wilk (S–W) và Kolmogorov–Smirnov (K–S). Nội dung sau trình bày nguyên lý hoạt động, cách diễn giải kết quả và những điểm cần lưu ý khi áp dụng hai kiểm định này trong SPSS.
1. Nguyên lý của kiểm định Shapiro–Wilk và Kolmogorov–Smirnov
Theo Andy Field (2009), một phương pháp phổ biến để xác định liệu dữ liệu có tuân theo phân phối chuẩn hay không là so sánh phân phối quan sát được với một phân phối chuẩn lý thuyết tương ứng, có cùng giá trị trung bình và độ lệch chuẩn. Hai kiểm định thường được sử dụng cho mục đích này là Kolmogorov–Smirnov và Shapiro–Wilk.
Về mặt khái niệm, có thể hình dung tồn tại một phân phối chuẩn lý thuyết làm chuẩn tham chiếu, ký hiệu là A, và phân phối của dữ liệu thực nghiệm cần đánh giá, ký hiệu là B. Hai phân phối này được chuẩn hóa về cùng trung bình và độ lệch chuẩn nhằm đảm bảo khả năng so sánh. Nếu phân phối B có mức độ tương đồng cao với phân phối A, dữ liệu được xem là đáp ứng giả định phân phối chuẩn. Ngược lại, nếu sự khác biệt giữa hai phân phối là đáng kể, dữ liệu được coi là không tuân theo phân phối chuẩn. Kiểm định Kolmogorov–Smirnov và Shapiro–Wilk được sử dụng để đánh giá mức độ khác biệt này.
Cách diễn giải kết quả của hai kiểm định được thực hiện thông qua giá trị xác suất sig.
- Khi kết quả kiểm định không có ý nghĩa thống kê (sig > 0.05), có thể kết luận rằng dữ liệu không khác biệt đáng kể so với phân phối chuẩn, do đó giả định phân phối chuẩn được chấp nhận.
- Ngược lại, khi kết quả kiểm định có ý nghĩa thống kê (sig < 0.05), dữ liệu được xem là khác biệt đáng kể so với phân phối chuẩn và không đáp ứng giả định này.
Mặc dù hai kiểm định trên mang lại sự thuận tiện trong việc đánh giá phân phối chuẩn thông qua một chỉ số duy nhất, chúng vẫn tồn tại những hạn chế nhất định. Cụ thể, trong trường hợp cỡ mẫu lớn, chỉ cần một sai lệch rất nhỏ so với phân phối chuẩn lý thuyết cũng có thể dẫn đến kết quả kiểm định có ý nghĩa thống kê. Khi đó, kiểm định có thể kết luận rằng dữ liệu không phân phối chuẩn, mặc dù mức độ sai lệch này trên thực tế không đủ lớn để ảnh hưởng đến các phân tích thống kê tiếp theo.
Ví dụ, giả sử dữ liệu về độ tuổi của 500 đối tượng được thu thập nhằm kiểm tra giả định phân phối chuẩn. Kết quả kiểm định Shapiro–Wilk cho thấy giá trị sig = 0.03, nhỏ hơn mức ý nghĩa 0.05, dẫn đến kết luận rằng dữ liệu không tuân theo phân phối chuẩn.
Tuy nhiên, khi quan sát biểu đồ Q–Q plot hoặc Histogram, có thể nhận thấy dữ liệu chỉ lệch nhẹ so với phân phối chuẩn và không xuất hiện các giá trị ngoại lai nghiêm trọng. Trong trường hợp này, các kiểm định thống kê tham số yêu cầu giả định phân phối chuẩn vẫn có thể được áp dụng mà không gây ảnh hưởng đáng kể đến độ chính xác của kết quả phân tích.
Lưu ý nhấn mạnh từ Andy Field (2009):
Trong các nghiên cứu sử dụng cỡ mẫu lớn, cả kiểm định Kolmogorov–Smirnov và Shapiro–Wilk đều có xu hướng rất nhạy, dẫn đến việc dễ phát hiện sự khác biệt có ý nghĩa thống kê ngay cả khi dữ liệu chỉ sai lệch rất nhỏ so với phân phối chuẩn. Andy Field (2009) chỉ ra rằng trong những trường hợp như vậy, kết quả có ý nghĩa thống kê không nhất thiết phản ánh sự vi phạm nghiêm trọng giả định phân phối chuẩn. Do đó, việc đánh giá tính chuẩn của dữ liệu không nên chỉ dựa đơn thuần vào các kiểm định thống kê này, mà cần kết hợp thêm các phương pháp bổ trợ như quan sát biểu đồ Histogram, biểu đồ P–P plot hoặc Q–Q plot, cùng với việc xem xét các chỉ số mô tả như độ lệch (skewness) và độ nhọn (kurtosis), nhằm đưa ra kết luận toàn diện và chính xác hơn.
2. Cỡ mẫu phù hợp của kiểm định Shapiro–Wilk và Kolmogorov–Smirnov
Theo đề xuất của Prabhakar Mishra và cộng sự (2019), việc lựa chọn kiểm định phân phối chuẩn cần được cân nhắc dựa trên cỡ mẫu nghiên cứu.
– Cụ thể, kiểm định Shapiro–Wilk được xem là phù hợp nhất khi cỡ mẫu nhỏ, đặc biệt là ≤ 50, do có độ nhạy cao trong việc phát hiện sự sai lệch so với phân phối chuẩn. Mặc dù vậy, kiểm định này vẫn có thể áp dụng cho các mẫu lớn hơn, thậm chí lên đến khoảng 2000 quan sát tùy thuộc vào phần mềm thống kê sử dụng, nhưng lợi thế rõ rệt nhất vẫn nằm ở các nghiên cứu có cỡ mẫu nhỏ.
– Ngược lại, kiểm định Kolmogorov–Smirnov thường được khuyến nghị sử dụng cho các mẫu có quy mô trung bình đến lớn, với cỡ mẫu từ 50 trở lên. Khi áp dụng cho mẫu nhỏ dưới 50, kiểm định này có độ nhạy thấp hơn, làm tăng khả năng không phát hiện được sự vi phạm giả định phân phối chuẩn hoặc cho ra kết quả sai lệch.
Các tác giả cho rằng mặc dù hai kiểm định Shapiro–Wilk và Kolmogorov–Smirnov có sự tương đồng trong mục tiêu đánh giá mức độ phù hợp của dữ liệu với phân phối chuẩn, nhưng Shapiro–Wilk thể hiện khả năng phát hiện sự khác biệt mạnh hơn. Điều này giải thích vì sao trong nhiều nghiên cứu thực nghiệm, kiểm định Shapiro–Wilk cho kết quả có ý nghĩa thống kê trong khi kiểm định Kolmogorov–Smirnov lại không, đặc biệt trong các trường hợp dữ liệu chỉ lệch nhẹ khỏi phân phối chuẩn.
Kết luận:
– Khi cỡ mẫu ≤ 50, nên ưu tiên sử dụng kiểm định Shapiro–Wilk.
– Khi cỡ mẫu ≥ 50, có thể sử dụng cả hai kiểm định, trong đó Shapiro–Wilk vẫn được đánh giá cao hơn nhờ độ nhạy lớn hơn.
– Việc đánh giá tính chuẩn của dữ liệu cần luôn kết hợp giữa kiểm định thống kê, quan sát trực quan thông qua các biểu đồ như Histogram và Q–Q plot, cùng với các chỉ số skewness và kurtosis để đưa ra nhận định đáng tin cậy hơn.
3. Kiểm định phân phối chuẩn bằng Shapiro-Wilk và Kolmogorov-Smirnov trong SPSS
3.1 Quy trình thực hiện kiểm định Shapiro-Wilk và Kolmogorov-Smirnov trong SPSS
Trong nghiên cứu này, một bộ dữ liệu minh họa với cỡ mẫu N = 200 được sử dụng để tiến hành đánh giá giả định phân phối chuẩn. Dữ liệu bao gồm ba biến định lượng cần kiểm định, cụ thể như sau:
– Biến HaiLong: được tính bằng giá trị trung bình của các biến quan sát thành phần, các biến này được đo lường bằng thang đo Likert 5 mức từ 1 đến 5.
– Biến DoTuoi: phản ánh độ tuổi của đối tượng khảo sát, dao động trong khoảng từ 19 đến 40 tuổi.
– Biến ThuNhap: thể hiện mức thu nhập hằng tháng của đáp viên, được đo lường theo đơn vị triệu đồng Việt Nam.
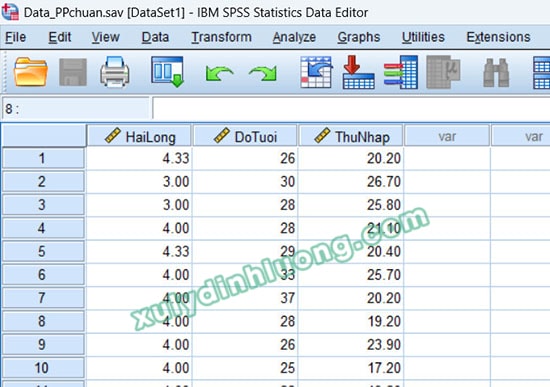
Để tiến hành kiểm định phân phối chuẩn bằng hai phép kiểm Shapiro-Wilk và Kolmogorov-Smirnov trong phần mềm SPSS, người nghiên cứu thực hiện theo đường dẫn Analyze > Descriptive Statistics > Explore.

Trong hộp thoại Explore, các biến định lượng cần kiểm định được đưa vào ô Dependent List bằng thao tác kéo-thả hoặc sử dụng nút mũi tên. Trường hợp nghiên cứu có nhu cầu đánh giá phân phối chuẩn theo từng nhóm đối tượng, biến phân nhóm có thể được đưa vào ô Factor List, chẳng hạn như biến giới tính. Sau đó, nhấp chọn nút Plots ở phía bên phải hộp thoại.

Tại hộp thoại Plots, người nghiên cứu lựa chọn các tùy chọn Stem-and-leaf và Histogram để hỗ trợ quan sát hình dạng phân phối dữ liệu. Đặc biệt, cần tích chọn mục Normality plots with tests nhằm yêu cầu SPSS thực hiện và hiển thị kết quả của hai kiểm định Shapiro-Wilk và Kolmogorov-Smirnov. Sau khi hoàn tất lựa chọn, nhấp Continue để quay lại hộp thoại trước.

Quay trở lại hộp thoại Explore, nhấn OK để phần mềm xuất kết quả phân tích ra cửa sổ Output. Kết quả bao gồm nhiều bảng biểu và đồ thị khác nhau phục vụ cho việc đánh giá giả định phân phối chuẩn của dữ liệu. Tuy nhiên, trong phạm vi nội dung này, phân tích chỉ tập trung vào bảng Tests of Normality, là bảng cung cấp trực tiếp giá trị thống kê và mức ý nghĩa của hai phép kiểm định Shapiro-Wilk và Kolmogorov-Smirnov.
3.2 Diễn giải kết quả kiểm định Shapiro-Wilk và Kolmogorov-Smirnov trong SPSS
Trong bảng Tests of Normality của phần mềm SPSS, kết quả đánh giá phân phối chuẩn được trình bày thông qua hai phép kiểm định chính là Kolmogorov-Smirnov và Shapiro-Wilk, kèm theo các tham số bao gồm:
- Statistic: Giá trị thống kê của phép kiểm định.
- Df (Degrees of Freedom): Số bậc tự do.
- Sig. (Asymp. Sig. (2-tailed)): Giá trị xác suất (mức ý nghĩa thống kê).
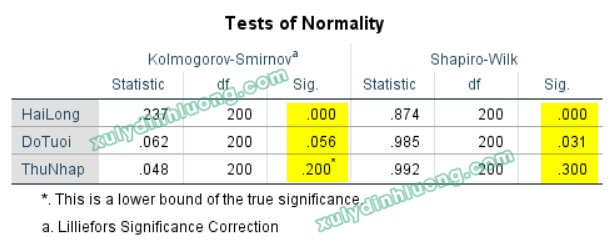
Kiểm định Shapiro-Wilk và Kolmogorov-Smirnov được sử dụng nhằm đánh giá giả thuyết dữ liệu tuân theo phân phối chuẩn.
Với cỡ mẫu nghiên cứu là 200 quan sát (lớn hơn 50), cả hai phép kiểm định Kolmogorov-Smirnov và Shapiro-Wilk đều có thể được áp dụng để xem xét tính phân phối chuẩn của các biến nghiên cứu.
Đối với biến HaiLong:
- Kết quả kiểm định Kolmogorov-Smirnov cho thấy giá trị Sig. bằng 0.000, nhỏ hơn mức ý nghĩa 0.05.
- Tương tự, kiểm định Shapiro-Wilk cũng cho giá trị Sig. bằng 0.000, nhỏ hơn 0.05.
→ Như vậy, cả hai phép kiểm định đều bác bỏ giả thuyết không, cho thấy biến HaiLong không tuân theo phân phối chuẩn.
Đối với biến DoTuoi:
- Kiểm định Kolmogorov-Smirnov cho giá trị Sig. bằng 0.056, lớn hơn 0.05, cho phép chấp nhận giả thuyết dữ liệu có phân phối chuẩn.
- Tuy nhiên, kết quả kiểm định Shapiro-Wilk lại cho giá trị Sig. bằng 0.031, nhỏ hơn hoặc bằng 0.05, cho thấy giả thuyết phân phối chuẩn bị bác bỏ.
Trường hợp này cho thấy sự không nhất quán nhất định giữa hai phép kiểm định. Với cỡ mẫu lớn (N = 200), kiểm định Kolmogorov-Smirnov thường được ưu tiên trong việc đưa ra kết luận. Tuy nhiên, do giá trị Sig. của Kolmogorov-Smirnov chỉ cao hơn ngưỡng 0.05 không đáng kể và kiểm định Shapiro-Wilk lại cho kết quả không đạt phân phối chuẩn, việc kết luận cần được hỗ trợ thêm bằng các phương pháp trực quan như biểu đồ Histogram kèm đường cong phân phối chuẩn, Q-Q plot, P-P plot, cũng như xem xét các chỉ số Skewness và Kurtosis.
Trong trường hợp các đồ thị phân phối và các chỉ số Skewness, Kurtosis cho thấy dữ liệu không lệch nhiều so với phân phối chuẩn, có thể chấp nhận rằng biến DoTuoi gần tiệm cận phân phối chuẩn. Tuy nhiên, kết quả của kiểm định Shapiro-Wilk cho thấy tín hiệu không chuẩn khá rõ ràng. Theo thông lệ trong phân tích thống kê, khi một trong hai kiểm định cho kết quả không đạt phân phối chuẩn, đặc biệt khi giá trị Sig. của phép kiểm định còn lại nằm sát ngưỡng ý nghĩa, kết luận thường nghiêng về việc dữ liệu không tuân theo phân phối chuẩn.
Đối với biến ThuNhap:
- Kết quả kiểm định Kolmogorov-Smirnov cho giá trị Sig. bằng 0.200, lớn hơn 0.05.
- Đồng thời, kiểm định Shapiro-Wilk cũng cho giá trị Sig. bằng 0.300, lớn hơn 0.05.
→ Cả hai phép kiểm định đều không bác bỏ giả thuyết phân phối chuẩn, cho thấy biến ThuNhap có phân phối chuẩn.
Kết luận chung:
Biến HaiLong không có phân phối chuẩn.
Biến DoTuoi có khả năng không tuân theo phân phối chuẩn và cần được kiểm chứng thêm thông qua các biểu đồ trực quan và chỉ số Skewness, Kurtosis để đưa ra kết luận cuối cùng.
Biến ThuNhap có phân phối chuẩn.
———-
Nguồn tham khảo:
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611.
Mishra P, Pandey CM, Singh U, Gupta A, Sahu C, Keshri A. Descriptive statistics and normality tests for statistical data. Ann Card Anaesth. 2019 Jan-Mar;22(1):67-72.
Field, A. (2009) Discovering Statistics Using SPSS. 3rd Edition, Sage Publications Ltd., London.