Bài viết này trình bày khái quát một quy trình phân tích dữ liệu bằng phần mềm SPSS thường được áp dụng trong các luận văn thạc sĩ và nghiên cứu sau đại học. Nội dung có thể được sử dụng như một tài liệu tham khảo nhằm hỗ trợ học viên cao học trong việc xây dựng cấu trúc phân tích dữ liệu và trình bày kết quả nghiên cứu một cách khoa học.
Trong các luận văn thạc sĩ sử dụng SPSS làm công cụ phân tích chính, quy trình kiểm định thường được triển khai theo sáu bước cơ bản như sau:
- Thứ nhất, thống kê mô tả, bao gồm thống kê tần số và thống kê giá trị trung bình.
- Thứ hai, kiểm định độ tin cậy của thang đo thông qua hệ số Cronbach’s Alpha.
- Thứ ba, phân tích nhân tố khám phá (Exploratory Factor Analysis – EFA).
- Thứ tư, phân tích tương quan tuyến tính Pearson.
- Thứ năm, phân tích hồi quy tuyến tính.
- Thứ sáu, phân tích sự khác biệt trung bình thông qua kiểm định T-test hoặc phân tích phương sai một yếu tố (One-way ANOVA).
1. Thống kê mô tả (Descriptive Statistics)
Trong SPSS, thống kê mô tả bao gồm tập hợp các công cụ được sử dụng nhằm mô tả và tóm tắt dữ liệu nghiên cứu thông qua các chỉ số như giá trị trung bình, độ lệch chuẩn, tần suất, tỷ lệ phần trăm, khoảng biến thiên, mode và trung vị. Các hình thức thống kê mô tả có thể kể đến như thống kê tần số, thống kê trung bình, kiểm định chi bình phương hay bảng chéo. Tuy nhiên, trong nghiên cứu luận văn, hai hình thức được sử dụng phổ biến nhất là thống kê tần số và thống kê trung bình.
a. Thống kê tần số (Frequency)
Thống kê tần số được sử dụng nhằm mô tả tổng quát đặc điểm của mẫu nghiên cứu cũng như phân bố các biến quan sát thu thập được từ khảo sát. Thông qua thống kê tần số, người nghiên cứu có thể xác định các đặc điểm nhân khẩu học của mẫu, chẳng hạn như tỷ lệ giới tính, phân bố địa lý, độ tuổi hoặc các đặc điểm nền tảng khác của đối tượng khảo sát.
Kết quả thống kê tần số trong SPSS thường bao gồm bảng tần số, tỷ lệ phần trăm của các nhóm đáp viên và các dạng biểu đồ minh họa như biểu đồ cột hoặc biểu đồ tròn tương ứng với bảng số liệu.

→ Dựa trên bảng tần số và tỷ trọng đáp viên, nhà nghiên cứu tiến hành mô tả đặc điểm của đối tượng khảo sát, chẳng hạn như xu hướng nghiêng về nam hay nữ, tập trung chủ yếu ở nhóm tuổi trẻ, trung niên hay cao tuổi, hoặc thuộc nhóm lao động phổ thông hay lao động văn phòng. Thông qua đó, có thể đánh giá mức độ phù hợp của mẫu nghiên cứu so với mục tiêu và phạm vi của đề tài, từ đó đưa ra các điều chỉnh cần thiết đối với mẫu nếu cần.
Ví dụ, trong một nghiên cứu về hành vi sử dụng mạng xã hội của giới trẻ, dữ liệu được thu thập thông qua khảo sát ngẫu nhiên diện rộng. Khi tiến hành thống kê tần số đối với biến độ tuổi, kết quả cho thấy nhóm đáp viên trên 30 tuổi chiếm tỷ trọng lớn trong mẫu. Trong trường hợp này, nhà nghiên cứu cần loại bỏ các quan sát không phù hợp với đối tượng nghiên cứu. Nếu cỡ mẫu còn lại sau khi sàng lọc vẫn đáp ứng yêu cầu mẫu tối thiểu, dữ liệu sẽ được giữ lại để tiếp tục phân tích. Ngược lại, nếu cỡ mẫu không đạt yêu cầu, cần tiến hành thu thập bổ sung dữ liệu để đảm bảo độ tin cậy và giá trị suy rộng của nghiên cứu.
b. Thống kê trung bình (Descriptives)
Trong khi thống kê tần số chủ yếu tập trung mô tả mức độ xuất hiện và tỷ trọng của các đặc điểm trong mẫu nghiên cứu, thì thống kê trung bình hướng đến việc cung cấp các chỉ số tổng hợp của biến nghiên cứu, bao gồm giá trị nhỏ nhất, giá trị lớn nhất, giá trị trung bình và độ lệch chuẩn. Những chỉ số này giúp khái quát hóa đặc điểm phân bố dữ liệu và là cơ sở quan trọng cho các phân tích tiếp theo.
Kết quả thống kê trung bình được xuất ra từ phần mềm SPSS thường bao gồm bảng thể hiện giá trị nhỏ nhất, giá trị lớn nhất, giá trị trung bình và độ lệch chuẩn của từng biến nghiên cứu.
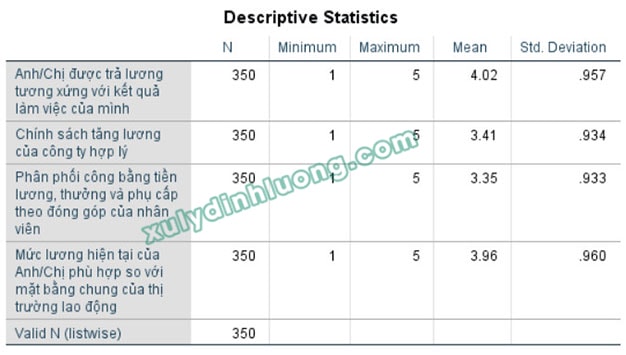
→ Trong quy trình phân tích dữ liệu bằng SPSS, việc dựa trên kết quả thống kê trung bình cho phép nhà nghiên cứu xác định phạm vi biến thiên của biến thông qua giá trị nhỏ nhất và giá trị lớn nhất. Từ đó, có thể đánh giá mức độ phù hợp của dữ liệu với bản chất và thiết kế của nghiên cứu.
Ví dụ, nếu một câu hỏi được đo lường bằng thang đo Likert 5 mức độ từ 1 đến 5, nhưng kết quả thống kê trung bình cho thấy giá trị nhỏ nhất là 0 và giá trị lớn nhất là 55, điều này cho thấy dữ liệu tồn tại sai lệch hoặc lỗi nhập liệu, đòi hỏi nhà nghiên cứu phải kiểm tra, làm sạch và xử lý dữ liệu trước khi tiếp tục phân tích.
→ Bên cạnh đó, giá trị trung bình cho biết mức độ trung tâm của biến nghiên cứu so với khoảng giá trị nhỏ nhất và lớn nhất, qua đó hỗ trợ đánh giá mức độ tích cực hay tiêu cực của yếu tố đang được xem xét, từ đó xác định cần duy trì hay cải thiện yếu tố đó.
Chẳng hạn, đối với câu hỏi A sử dụng thang đo Likert 5 mức độ với mức độ đồng ý tăng dần từ 1 đến 5, trong đó 1 là rất không đồng ý và 5 là rất đồng ý. Nếu kết quả thống kê cho thấy giá trị trung bình của A là 1,82, mức điểm này gần với giá trị 2 và thấp hơn mức trung lập là 3, có thể kết luận rằng phần lớn người trả lời không đồng ý với nhận định được đưa ra trong câu hỏi.
2. Phân tích độ tin cậy Cronbach’s Alpha
Kiểm định độ tin cậy Cronbach’s Alpha là một bước không thể thiếu trong quá trình phân tích dữ liệu bằng SPSS, nhằm đánh giá mức độ nhất quán nội tại của các thang đo dùng để đo lường từng yếu tố trong mô hình nghiên cứu. Việc sử dụng Cronbach’s Alpha tập trung vào hai nhiệm vụ chính như sau:
- Thứ nhất, đánh giá mức độ phù hợp của các biến quan sát (câu hỏi) được sử dụng để đo lường cùng một yếu tố. Những biến quan sát không phản ánh tốt khái niệm nghiên cứu hoặc có mức độ tương quan thấp với tổng thang đo sẽ được xem xét loại bỏ, chỉ giữ lại các biến có ý nghĩa và đóng góp tích cực vào thang đo.
- Thứ hai, đánh giá độ tin cậy tổng thể của tập hợp các biến quan sát đại diện cho một yếu tố. Trong trường hợp các biến không phù hợp đã được loại bỏ nhưng thang đo vẫn không đạt ngưỡng độ tin cậy cần thiết, nhà nghiên cứu cần cân nhắc loại bỏ yếu tố đó khỏi mô hình nghiên cứu hoặc điều chỉnh, bổ sung lại hệ thống câu hỏi đo lường.
Xem thêm chi tiết bài viết và video hướng dẫn thực hiện kiểm định độ tin cậy Cronbach’s Alpha.
Kết quả phân tích Cronbach’s Alpha trong SPSS thường được thể hiện qua hai bảng kết quả quan trọng:
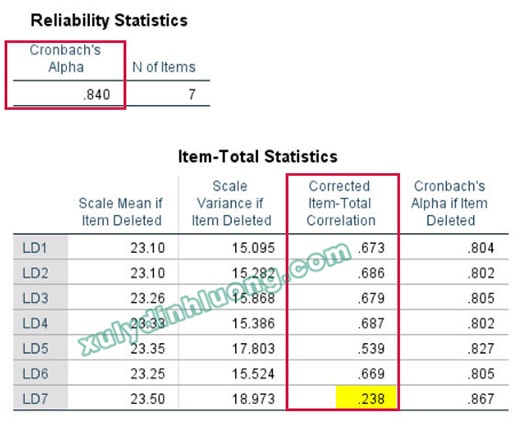
→ Bảng Reliability Statistics cung cấp giá trị hệ số Cronbach’s Alpha, phản ánh mức độ tin cậy của thang đo đối với từng nhân tố. Theo thông lệ trong nghiên cứu khoa học xã hội, thang đo được chấp nhận khi hệ số Cronbach’s Alpha đạt từ 0.7 trở lên.
→ Bảng Item – Total Statistics cung cấp hệ số tương quan biến-tổng đã hiệu chỉnh, dùng để đánh giá mức độ đóng góp của từng biến quan sát trong thang đo. Các biến có giá trị Corrected Item – Total Correlation từ 0.3 trở lên được xem là đạt yêu cầu và đảm bảo độ tin cậy khi đo lường nhân tố nghiên cứu.
3. Phân tích nhân tố khám phá EFA
Trong quy trình phân tích dữ liệu bằng SPSS phục vụ luận văn cao học, việc thực hiện phân tích nhân tố khám phá EFA phụ thuộc vào đặc điểm và mục tiêu của đề tài nghiên cứu, cụ thể là nghiên cứu mang tính lặp lại hay mang tính khám phá. Đối với một số nghiên cứu lặp lại, giảng viên hướng dẫn có thể yêu cầu không tiến hành phân tích EFA mà chuyển trực tiếp sang các bước phân tích tương quan và hồi quy sau khi hoàn thành kiểm định độ tin cậy thang đo bằng Cronbach’s Alpha.
Phân tích nhân tố khám phá (Exploratory Factor Analysis – EFA) được sử dụng nhằm rút gọn tập hợp nhiều biến quan sát được xây dựng trong bảng câu hỏi thành một số lượng nhân tố ít hơn nhưng có ý nghĩa thống kê và khái niệm, phục vụ cho các phân tích tương quan và hồi quy ở các bước tiếp theo. Cụ thể, phân tích EFA có các nhiệm vụ chính sau:
-
Xác định số lượng nhân tố được trích xuất từ tập hợp các biến quan sát ban đầu.
-
Đánh giá mức độ hội tụ và phân biệt của các thang đo nhân tố.
-
Phát hiện và loại bỏ các biến quan sát không phù hợp với mô hình nghiên cứu.
Xem thêm chi tiết bài viết và video hướng dẫn thực hiện phân tích nhân tố khám phá EFA tại đây.
Kết quả đầu ra của phân tích EFA trên phần mềm SPSS thường bao gồm ba bảng kết quả quan trọng, cụ thể như sau:
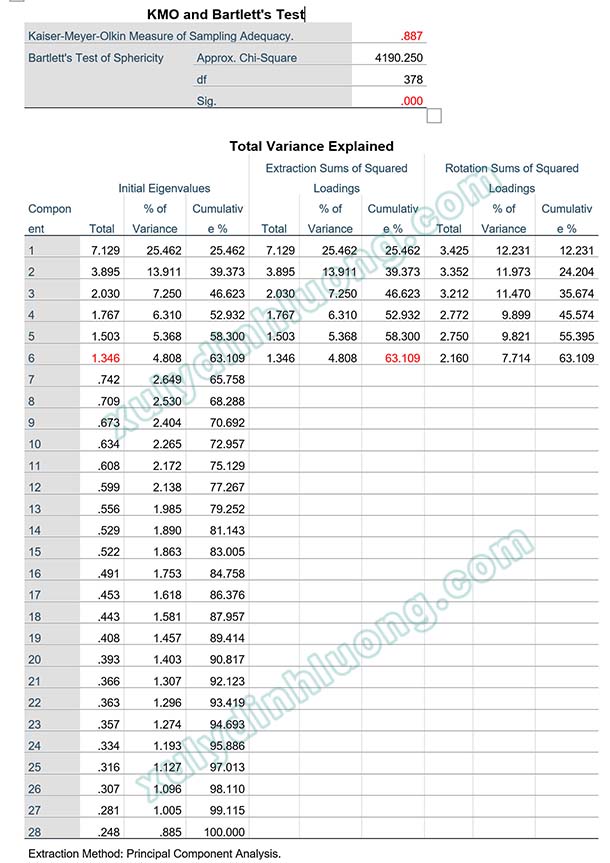
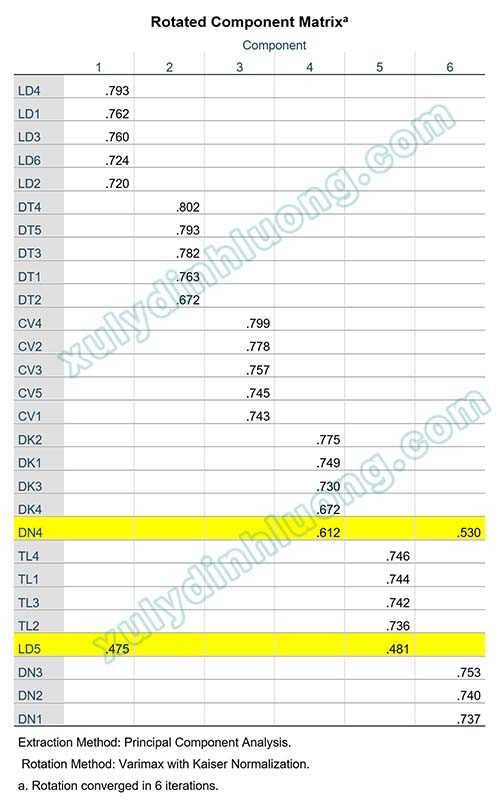
→ Bảng KMO and Bartlett’s Test cung cấp hệ số KMO và giá trị mức ý nghĩa của kiểm định Bartlett nhằm đánh giá mức độ phù hợp của dữ liệu đối với phân tích nhân tố. Theo tiêu chuẩn thống kê, hệ số KMO phải đạt từ 0,5 trở lên và giá trị sig của kiểm định Bartlett phải nhỏ hơn 0,05 thì phân tích EFA được xem là phù hợp và có thể sử dụng.
→ Bảng Total Variance Explained thể hiện tổng phương sai trích được giải thích bởi các nhân tố được rút ra từ mô hình. Tổng phương sai trích đạt từ 50% trở lên cho thấy các nhân tố trích xuất có khả năng giải thích tốt tập hợp các biến quan sát ban đầu và đáp ứng yêu cầu của nghiên cứu.
→ Bảng Rotated Component Matrix cung cấp thông tin về hệ số tải nhân tố của từng biến quan sát, từ đó đánh giá mức độ hội tụ và phân biệt giữa các nhân tố. Đồng thời, bảng này cho phép xác định chất lượng của từng biến quan sát và làm căn cứ để quyết định giữ lại hay loại bỏ các biến không đạt yêu cầu.
4. Phân tích tương quan Pearson
Phân tích tương quan Pearson thường được tiến hành trước bước phân tích hồi quy trong quy trình xử lý và phân tích dữ liệu bằng phần mềm SPSS. Mục tiêu của phương pháp này là đánh giá mức độ và chiều hướng mối quan hệ tuyến tính giữa biến phụ thuộc và các biến độc lập, đồng thời hỗ trợ phát hiện sớm hiện tượng đa cộng tuyến thông qua việc xem xét mối tương quan giữa các biến độc lập với nhau.
Xem thêm chi tiết bài viết và video hướng dẫn thực hiện phân tích tương quan Pearson tại đây.
Kết quả phân tích tương quan Pearson trên SPSS bao gồm hệ số tương quan Pearson và giá trị sig dùng để kiểm định ý nghĩa thống kê của hệ số tương quan.
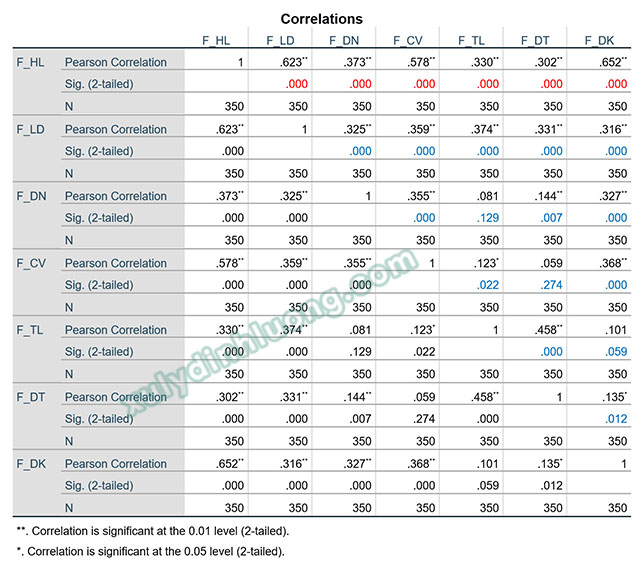
→ Trong nghiên cứu định lượng, thông thường kỳ vọng giá trị sig của mối tương quan giữa biến độc lập và biến phụ thuộc nhỏ hơn 0,05, cùng với hệ số tương quan tương đối cao, nhằm chứng minh sự tồn tại của mối liên hệ có ý nghĩa giữa các biến và tạo cơ sở cho việc thực hiện phân tích hồi quy tiếp theo.
→ Bên cạnh đó, hệ số tương quan giữa các biến độc lập thường được kỳ vọng không vượt quá mức 0,5 để hạn chế nguy cơ xảy ra hiện tượng cộng tuyến hoặc đa cộng tuyến. Trong trường hợp này, giá trị sig của mối tương quan giữa các biến độc lập không được xem là yếu tố có ý nghĩa quyết định.
5. Phân tích hồi quy tuyến tính bội
Phân tích hồi quy tuyến tính bội là bước phân tích then chốt trong quy trình xử lý dữ liệu bằng phần mềm SPSS đối với luận văn cao học, vì đây là giai đoạn trực tiếp kiểm định các giả thuyết nghiên cứu và đánh giá mức độ phù hợp của mô hình nghiên cứu đề xuất. Thông qua phân tích hồi quy, nghiên cứu tập trung thực hiện các nội dung sau:
- Thứ nhất, xác định các biến độc lập trong mô hình có ảnh hưởng có ý nghĩa thống kê đến biến phụ thuộc.
- Thứ hai, đánh giá mức độ tác động mạnh hay yếu của từng biến độc lập đối với biến phụ thuộc.
- Thứ ba, xác định chiều hướng tác động của các biến độc lập lên biến phụ thuộc, bao gồm tác động cùng chiều hoặc ngược chiều.
- Thứ tư, đánh giá mức độ ảnh hưởng tổng thể của toàn bộ các biến độc lập đối với biến phụ thuộc trong mô hình nghiên cứu.
Xem thêm chi tiết bài viết và video hướng dẫn thực hiện phân tích hồi quy tuyến tính bội tại đây.
Kết quả phân tích hồi quy tuyến tính bội trên SPSS được thể hiện thông qua ba bảng kết quả quan trọng, bao gồm bảng ANOVA, bảng Model Summary và bảng Coefficients.
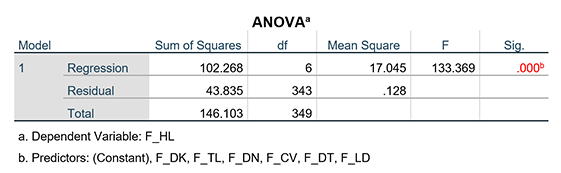
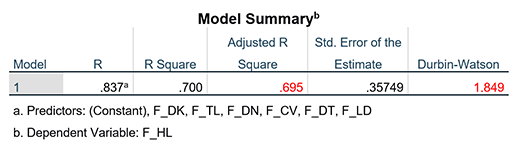

→ Bảng ANOVA cung cấp giá trị sig của kiểm định F nhằm đánh giá sự phù hợp tổng thể của mô hình hồi quy. Khi giá trị sig nhỏ hơn 0.05, mô hình hồi quy được xem là có ý nghĩa thống kê và phù hợp để sử dụng cho phân tích tiếp theo.
→ Bảng Model Summary trình bày các chỉ số R bình phương và R bình phương hiệu chỉnh, phản ánh mức độ giải thích của các biến độc lập đối với sự biến thiên của biến phụ thuộc, từ đó đánh giá mức độ ảnh hưởng chung của mô hình nghiên cứu.
→ Bảng Coefficients cung cấp giá trị sig của kiểm định t nhằm xác định ý nghĩa thống kê của từng biến độc lập trong mô hình. Khi giá trị sig nhỏ hơn 0.05, biến độc lập được kết luận là có ảnh hưởng đến biến phụ thuộc. Đồng thời, bảng này còn thể hiện hệ số hồi quy chưa chuẩn hóa B và hệ số hồi quy chuẩn hóa Beta, cho phép đánh giá mức độ tác động tương đối cũng như chiều hướng tác động của các biến độc lập đối với biến phụ thuộc.
6. Phân tích sự khác biệt về giá trị trung bình bằng T Test và One-way ANOVA
Ở bước thứ sáu trong quy trình xử lý dữ liệu bằng SPSS cho luận văn thạc sĩ, phân tích được triển khai ở mức độ chuyên sâu hơn nhằm cung cấp cơ sở khoa học cho việc đề xuất các giải pháp và kiến nghị nghiên cứu.
Trong nhiều nghiên cứu thực nghiệm, nhu cầu so sánh giá trị trung bình của một biến nghiên cứu giữa hai hoặc nhiều nhóm đối tượng là rất phổ biến. Mỗi phép kiểm định sự khác biệt trung bình bao gồm hai loại biến: một biến định lượng dùng để tính giá trị trung bình và một biến định tính dùng để phân nhóm so sánh.
Chẳng hạn, nghiên cứu có thể xem xét sự khác biệt về mức độ hài lòng trong công việc giữa nam và nữ, hoặc so sánh mức độ hài lòng giữa các nhóm thu nhập dưới 10 triệu đồng, từ 10 đến 20 triệu đồng và trên 20 triệu đồng.
→ Việc đánh giá sự khác biệt này giúp nhận diện các khác biệt về nhận thức và hành vi giữa các nhóm đáp viên có đặc điểm cá nhân khác nhau, từ đó làm cơ sở cho việc đề xuất các giải pháp và định hướng xử lý phù hợp với từng nhóm đối tượng nghiên cứu.
a. Kiểm định Independent-Samples T Test
Kiểm định Independent-Samples T Test được sử dụng khi nghiên cứu nhằm so sánh giá trị trung bình của một biến định lượng giữa hai nhóm đối tượng độc lập. Ví dụ, so sánh mức chi tiêu trung bình hàng tháng giữa các hộ gia đình chưa có con và các hộ gia đình có con dưới 6 tuổi. Trong trường hợp này, biến định lượng là mức chi tiêu hàng tháng, còn biến định tính dùng để phân nhóm gồm hai giá trị, trong đó nhóm 1 là hộ gia đình chưa có con và nhóm 2 là hộ gia đình có con dưới 6 tuổi.
Xem thêm chi tiết bài viết và video hướng dẫn thực hiện phân tích Independent Sample T Test tại đây.
Kết quả phân tích Independent-Samples T Test trên SPSS cung cấp giá trị sig của kiểm định t.

→ Nếu giá trị sig nhỏ hơn mức ý nghĩa 0.05, có thể kết luận rằng tồn tại sự khác biệt có ý nghĩa thống kê về giá trị trung bình của biến nghiên cứu giữa hai nhóm đối tượng.
b. Kiểm định One-way ANOVA
Kiểm định Independent-Samples T Test chỉ cho phép so sánh giá trị trung bình giữa hai nhóm. Khi biến định tính có từ ba nhóm trở lên, phương pháp phân tích phù hợp là kiểm định One-way ANOVA, còn được gọi là phân tích phương sai một chiều.
Xemthêm chi tiết bài viết và video hướng dẫn thực hiện phân tích One-way ANOVA tại đây.
Phân tích One-way ANOVA cho phép đánh giá sự khác biệt về giá trị trung bình của một biến định lượng giữa nhiều nhóm đối tượng khác nhau trong cùng một mô hình. Kết quả phân tích trên SPSS thường thể hiện thông qua giá trị sig của kiểm định F hoặc kiểm định Welch trong trường hợp giả định phương sai bằng nhau không được thỏa mãn.
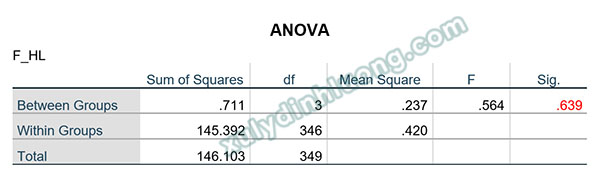
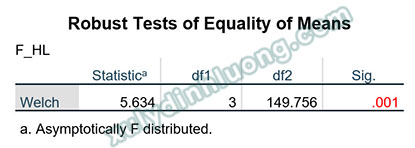
→ Nếu giá trị sig nhỏ hơn 0.05, có thể kết luận rằng tồn tại sự khác biệt có ý nghĩa thống kê về giá trị trung bình giữa các nhóm đối tượng nghiên cứu.
Như vậy, sáu nhóm kiểm định cơ bản nêu trên là những kỹ thuật thống kê thường được sử dụng trong phân tích dữ liệu SPSS cho luận văn thạc sĩ và cao học. Tùy thuộc vào đặc điểm và mục tiêu của từng đề tài, nghiên cứu có thể cần bổ sung các kiểm định khác như kiểm định Chi bình phương, phân tích bảng chéo, các phương pháp phi tham số hoặc thực hiện thêm phân tích CFA bằng AMOS sau bước EFA. Do đó, học viên cần trao đổi và tuân thủ sự hướng dẫn của giảng viên hướng dẫn để xây dựng quy trình nghiên cứu phù hợp và đảm bảo tính khoa học của luận văn.